2025年2月27日木曜日

自分史年表

NHKアーカイブスに自分史年表という企画が出現していた。たぶん,放送100年に絡めたものだ。自分の生年(1953など)と,ジャンル(ニュース,番組,大河ドラマ,連続テレビ小説,こども番組,スポーツ)を入れると,自分が何歳の年にどんなトピックがあったかの一覧が表示される。クリックすると短い映像が再生され,そのときどんなことがあったかがわかる。

ニュースを選ぶと,主に事故災害や皇室関係や国内政治などの話題が数編選択されてくる。1964年に東京オリンピックが,1972年に札幌オリンピックが出てこないのは権利関係からなのだろうか。NHKの関心がメインになっているので,必ずしも世界史的な重要事項が網羅されているわけではない。

そこで,Gemini 2.0 Flashに別の観点で尋ねてみた。
Q(koshix):
1950年から1975年までで,毎年1つだけ出来事を選んでください。
それは,日本史的あるいは世界史的に長い歴史の中で重要な意義を持つものとします。

A(Gemini 2.0 Flash):
(回答はのちほど)

Q(koshix):
文化,科学,技術の革新的な出来事の方が長期的な影響が大きい場合があるのではないでしょうか。その観点も含めて,再度,1950-1975年までの各年のトピック一つを選び直してください。それを考慮した上で先ほどと同じものになってもまったく構いません。

A(Gemini 2.0 Flash):
(上記2つ回答を上下に整理して,それらの説明を省いて項目だけ並べたもの)

1950年:朝鮮戦争勃発
    トランジスタラジオの登場
1951年:サンフランシスコ平和条約調印○
    ENIACの後継機UNIVAC Iの商用利用開始
1952年:日本の主権回復
1953年:スターリン死去
    DNAの二重らせん構造の発見
1954年:ビキニ環礁での水爆実験○
    世界初のカラーテレビ放送
1955年:バンドン会議(アジア・アフリカ会議)開催
1956年:日ソ共同宣言調印○
1957年:ソ連、スプートニク1号打ち上げ○
    同上
1958年:東京タワー完成○
    集積回路(IC)の発明
1959年:キューバ革命
    リチウムイオン電池の基礎研究開始?
1960年:日本で安保闘争○
    レーザーの発明
1961年:ベルリンの壁建設
    ボストーク1号による世界初の有人宇宙飛行○
1962年:キューバ危機
    通信衛星テルスター1号打ち上げ
1963年:ケネディ大統領暗殺○
    ARPANETの始動? → 1969年運用開始
1964年:東京オリンピック開催
1965年:日韓基本条約締結○
    FORTRANによるプログラムでのCADシステムの実用化?
1966年:中国で文化大革命開始
    世界初の人工心臓の臨床応用?
1967年:日本で公害対策基本法制定
1968年:プラハの春
    マウスの発明
1969年:アポロ11号月面着陸○
    同上
1970年:大阪万博開催○
1971年:ニクソン・ショック○
1972年:沖縄返還○
    CTスキャンの実用化
1973年:第四次中東戦争とオイルショック○
    遺伝子組み換え技術の確立
1974年:ウォーターゲート事件
1975年:ベトナム戦争終結○


図:自分史年表1953の例(NHKアーカイブスから引用)

どう考えても下段の方が重要ではないか。しかも現代文明の鍵となる重要な情報関連技術のほとんどが1950年から1975年の間に実現されている。ただし,生成AIのことだからハルシネーションが少し混在しているかもしれない。?のついた項目は事実確認ができなかった。上段の○つきの項目がNHKの自分史年表に採用されていたものになる。

2025年2月26日水曜日

初歩からの物理


午前9:00を過ぎたNHKでは国会中継が始まったので,BSの放送大学に切り替えたら,岸根順一郎(1967-)さんの「初歩からの物理」をやっていた。そのテロップに,この授業を共に担当している松井哲男(1953-2025)さんが1月5日にご逝去されたとあってビックリした。

松井さんは自分より1学年上だ。学会や研究会の同世代や少し上の学年というと,京大では国広悌二さんや巽敏隆さん,東大では岡真さんや星紀行さん,名大では松井哲男さんや乙藤岳志さんらをよく見かけて話をきいた。京大と名大のグループは当時流行のパイオン凝縮(続)の話題に集まっており,東大グループは核力とクォーク模型について研究を進めていた。いずれも原子核理論の中間エネルギーという分野の話だ。自分はベータ崩壊なので中間エネルギーにも届かないのだけれど。

京大グループの話はモデルとしてはわかりやすかったが(それでも怪しかった),名大グループのそれはあまりよく理解できなかった(物性物理の知識不足からか)。1980年の国際会議のときに記念写真をとって,その後海外に旅立つことになっていた松井さんから送られてきた。お礼の返事をすればよいものの,こしぎりならずいつものように不義理のため放置したままだった。よくないです。

松井さんは岐阜高だから水野義之(1953-)さんと同窓か。京大理学部から大学院で名大の安野愈さんの研究室に進む。1980年からアメリカに渡り,スタンフォード,LBL,MITを経て1993年に京大の基研,1999年から東大の駒場,2015年から放送大学でそれぞれ教授を勤めていた。

放送大学のチャンネルで拝見する限りはお元気そうだったのだけれど。合掌。


写真:放送大学「初歩からの物理」の松井さん(放送大学から引用)


P. S. 原子核理論では若くて亡くなる人が多かった。いやどの分野でもそんなものかもしれない。有馬研の星紀行さんも1980年代に亡くなっている。大坪先生がハイパー核での研究を期待していたのに残念だったと話していたかもしれない。京大で原子核の有効相互作用を研究していた安藤和彦さんと坂東弘治さん。RCNPの理論部にいた後輩の深山良徳君と名大から甲南大学にいった西岡英寿さんは1990年代半ば。最近だと大西明さんなどなど。


P. S. 池上彰が気持ち悪いのはマンスプレイニングだからだ。と誰かがYouTubeで話していたが,それはブラタモリにもいえる。大橋巨泉もそうだった。放送大学の物理などの時間もキッチリあてはまるのだ。自分のブログだってそうかも。いかんともしがたい・・・。みんな少しずつ気持ち悪い。


[2]Quest for the Quark-Gluon Plasma(2013, T. Matsui)

2025年2月25日火曜日

電子教科書(4)

電子教科書(3)からの続き

岡口基一さんによると,xAIのGrok 3(x.comで絶賛無料公開中)を使っていろんな物事を盛大にディスるという祭りが流行っているらしい。早速便乗してみた。人間として非情に安易な態度ではある。

Q(koshix):
日本のGIGAスクール及びデジタル教科書政策の問題点を壮大にディスってください。哲学的観点,教育学的観点,社会学的観点から,より理論的で本質的な問題点を指摘したうえで,こき下ろしてください。

A(Grok 3 beta):
日本のGIGAスクール構想とデジタル教科書政策は、表面的な「先進性」を追い求めるあまり、教育の本質を見失った愚策と言わざるを得ません。哲学的、教育学的、社会学的観点からその問題点を解剖し、その無思慮な推進ぶりを盛大にこき下ろしてみましょう。

哲学的観点:存在の意味と技術の隷属
まず哲学的に見れば、GIGAスクール構想は人間の存在意義を技術に矮小化する愚行です。ハイデガーの「技術への問い」を借りれば、現代社会は技術を単なる道具ではなく、世界を支配する枠組み(ゲシュテル)として扱い、その結果、人間が技術の奴隷と化しています。デジタル教科書を押し付けるこの政策は、子供たちに「学びとは何か」「生きるとはどういうことか」を自ら思索する機会を奪い、スクリーンの中の情報に盲従する存在へと貶めます。紙の教科書を手に持つ重み、ページをめくる行為、そこに潜む時間の感覚——これらは単なる「古さ」ではなく、人間が世界と向き合う具体的な経験です。それをデジタルという無機質な虚構に置き換えるのは、学ぶ者の実存を剥奪する暴挙に他なりません。文科省は、技術の進歩を「進化」と勘違いし、人間の本質を切り捨てる亡魂と化しているのです。恥を知れと言いたい。

教育学的観点:学びの深さと記憶の喪失
教育学的に見ても、この政策は子供たちの認知能力と学びの質を破壊する時限爆弾です。研究によれば、紙媒体での読書はデジタル画面に比べて深い理解と長期記憶の定着に優れていることが明らかになっています(例えば、Mangen & Schilhabの研究)。デジタル教科書は、動画や音声といった刺激を詰め込むことで「アクティブ・ラーニング」を装いますが、それは表層的な興奮にすぎず、思索や内省を育む時間を削ぎます。子供が自分で考え、試行錯誤し、知識を血肉化する過程——それこそが教育の核心なのに、GIGAスクールはそれを「効率化」の名の下に切り刻む。教師が熱意を持って語り、子供がノートに書き殴る泥臭い学びを、冷たいタブレット操作に置き換えるなんて、教育の魂を売り渡す行為です。ましてや、視力低下や集中力の散漫化といった健康面のリスクを無視してまで推進するその傲慢さは、子供を人間ではなくデータ処理機とみなす冷血漢そのもの。こんな政策を「未来志向」と呼ぶなら、その未来はディストピア以外の何物でもありません。

社会学的観点:格差の増幅と共同体の崩壊
社会学的視点からは、GIGAスクールがもたらす格差の拡大と社会共同体の解体が深刻です。端末の整備や通信環境は一見「平等」を装いますが、現実は富裕層と貧困層の間でデジタルリテラシーの差が広がるばかり。家庭でのサポートが乏しい子供は、タブレットの使い方すらままならず、授業についていけないという新たな「教育貧困」が生まれています。文科省は「1人1台」を錦の御旗に掲げますが、それが地方の過疎校や低所得家庭でどう機能するのか、実態を無視した絵空事でしかない。さらに、学校という共同体の場がデジタル化で希薄化し、教師と生徒、生徒同士の「顔の見える関係」が失われつつあります。紙の教科書を手に持つ子供たちが教室で議論し、互いに学び合う風景は、単なるノスタルジーではなく、社会を結ぶ絆の基盤です。それをデジタルという孤独な箱に閉じ込める政策は、子供たちを孤立した消費者へと変貌させ、協働の精神を根絶やしにする亡国への第一歩。こんなものを「教育改革」と呼ぶ神経が理解不能です。

総括:愚策の極み、文科省の自滅劇
結局、GIGAスクールとデジタル教科書政策は、哲学的には人間の存在を空洞化し、教育学的には学びの本質を殺し、社会学的には格差と孤立を助長する三重の罪を犯しています。文科省は「国際競争力」や「ICT活用」を振りかざしますが、それは子供の未来を顧みない官僚の自己満足にすぎません。スウェーデンのような先進国がデジタルからアナログへ回帰する中、日本だけが時代遅れの「デジタル信仰」に突き進む姿は、滑稽を通り越して悲劇的です。こんな壮大な茶番を「構想」と銘打つその厚顔無恥さ、子供を実験台にする無責任さは、もはや救いようがない。いい加減目を覚まして、技術に溺れたこの愚策を葬り去るべきです。文科省よ、歴史に汚点を刻む前に悔い改めなさい!


図:上記結論を入れて生成させたイメージ(DALL-E3)

DALL-E3の知識は,1984年止まりのようだ。現実はもっと複雑でハッピーなクモの巣の網の中に絡められている。シンギュラリティ(最近はAGIとASIで置き換えられつつある)まであと何年。


2025年2月24日月曜日

電子教科書(3)

電子教科書(2)からの続き

ちょうど15年前の今ごろに,どうして電子教科書の実現が難しいのかを考えていた。それをChatGPT 4oに評価してもらう。まあ発問者のレベルが高くないので無難でそれらしい答えが返ってきてしまった。
Q(koshix):
15年前に考えた以下のハードルについて,現在の日本の状況を分析してみてください。

電子教科書10のハードル(2010.02.18 http://twilog.org/koshix)

1.学校教育は社会的な世代間の情報文化伝達の営みであり、それ自身を含めた社会システム維持を志向するという本質的に保守的な側面を持っている。

2.導入における社会的な総費用を考えた際の効用が正にならない。あるいはそれが既得権益集団の利益にならない。

3.近年の社会変動が大きすぎて教育行政や教員層が疲弊しており、この方向(ICT)での現状変革を望むベクトルが出てこない。

4.新しいメディアを従来の教育方法(そう簡単には変わらない)に継ぎ足すことが、本当に子どもの学びのプラスになるのか疑問である。

5.授業中の情報チャンネルが拡大拡散してしまうことで教師が教室の子ども達を十分に制御できなくなる。

6.印刷メディアは最も歴史が長く蓄積も大きいため、その電子化に対するしきいは他のメディアの比ではない。

7.各種団体企業組織の利害対立からユーザインターフェースやユーザビリティーについての包括的な議論が困難である。

8.システムの安定性や堅牢性、電力・情報供給ルート及びその保守維持など実運用に関する大きな課題がある。

9.電子教科書=電子ノートに書き込まれる膨大な個人情報の管理の問題や日本における著作権の壁などから利用に大きな制約が生じてしまう。

10.あなたにとっても最も大きな障壁は何ですか?


A(ChatGPT 4o):
15年前(2010年)に指摘された「電子教科書10のハードル」について、現在(2025年)の日本の状況を踏まえて、それぞれの項目がどの程度解消・変化しているかを分析してみます。

1.学校教育は本質的に保守的な側面を持つ
現状分析: この点は依然として大きな課題です。
特に日本の教育現場は、中央集権的な教育行政の影響が強く、新しいテクノロジーの導入には慎重な姿勢が続いています。ただし、2020年以降のGIGAスクール構想によって、小中学生向けの1人1台端末の普及が進み、デジタル教材の活用は増えています。しかし、授業の基本形態(板書・教科書ベース)や指導方法の根幹は大きく変わっていません。

2.総費用の効用が正にならない/既得権益集団の影響
現状分析: 導入コストの問題は依然として大きく、全国規模での電子教科書の完全導入は進んでいません。一方で、GIGAスクール構想により、端末配布やインフラ整備の費用は国が一部負担する形で進みました。しかし、教科書出版社や印刷業界との利害関係は根強く、紙の教科書と電子教科書の「併用」という形にとどまっています。

3.教育行政や教員層の疲弊
現状分析: この課題はさらに深刻化しています。
GIGAスクール構想による端末配布は行われたものの、教員のITリテラシー向上やデジタル教材の活用指導に関する支援は不十分です。業務過多の状況が続いており、「ICT活用の負担増」を懸念する教員も多く、積極的な変革の動きにはなっていません。

4.新メディアの導入が本当に学びにプラスになるのか?
現状分析: この点に関しては、学習効果の検証が進んでいます。
研究によると、電子教科書の活用は「個別最適化学習」や「アクティブラーニング」には有効である一方で、紙の教科書よりも記憶の定着が劣る場合があることも指摘されています。そのため、完全なデジタル化ではなく、紙と電子のハイブリッド型が主流になりつつあります。

5.教室での制御困難の問題
現状分析: この問題も未解決です。
特に、小中学校では「授業中の端末利用ルールの統一」や「ICT活用に慣れていない教員の対応能力不足」により、端末を効果的に活用できないケースが多く見られます。一方で、MDM(モバイルデバイス管理)技術の発展により、使用制限や一括管理が可能になってきましたが、現場の運用が追いついていません。

6.印刷メディアの蓄積と電子化のハードル
現状分析: この問題は徐々に緩和されています。
デジタル教科書は一部の科目(英語・数学など)で普及しつつありますが、紙媒体の教科書の完全電子化は進んでいません。その背景には、著作権や教育現場の慣習の問題があるほか、「紙の方が学習しやすい」という意見も根強くあります。

7.ユーザインターフェース・ユーザビリティの議論困難
現状分析: この問題はやや改善しています。
近年の電子教科書は、学習履歴の管理やアクティブラーニング機能の充実など、ユーザビリティの向上が進んでいます。ただし、異なる企業が開発するシステム間の互換性や、端末ごとの操作性の違いなど、統一的なUI/UXの確立には至っていません。

8.システムの安定性・電力供給・保守の課題
現状分析: 技術的なインフラ整備は進んでおり、Wi-Fi環境やクラウドベースの学習管理システム(LMS)の普及も進みました。しかし、電力供給や端末の維持管理(特に故障・更新の問題)は依然として課題です。また、災害時の対応(停電時に使えない、通信が途絶えた場合の代替手段)についても、十分な解決策は確立されていません。

9.個人情報・著作権の問題
現状分析: 個人情報保護の観点から、電子教科書のログデータ管理や、生成AI活用による学習支援の可否が議論されています。
また、教科書のデジタル化においては、出版社側の著作権管理の厳格化が課題となり、自由な二次利用やカスタマイズが制限されている現状があります。特に、日本の著作権法は教育分野でのデジタル活用に関してまだ柔軟性が低く、欧米に比べて遅れています。

10.現在の最大の障壁
現在の最大の障壁を挙げるとすれば、以下の3つが考えられます。

(1) 「電子教科書=紙の代替」ではなく、教育の質をどう向上させるかの議論が不足
・電子化の目的が明確でないまま、ハードウェア導入が進んでしまい、効果的な活用ができていない。
(2) 教員のITリテラシーと運用負担
・ICT活用を前提としたカリキュラム改革や、教員の研修体制が不十分。
(3) コストと維持管理の問題
・端末の更新費用や、デジタルコンテンツの継続的なライセンス料が自治体にとって大きな負担。

結論
15年前に指摘されたハードルの多くは、2025年現在でも完全には解決されていません。ただし、一部の技術的課題(インフラ整備・管理技術の向上)は改善されました。今後の鍵は、「電子教科書をどう活用するか?」という教育の本質的な議論と、「教員の負担軽減をどう実現するか?」という制度設計の部分にあると考えられます。

2025年2月23日日曜日

電子教科書(2)

電子教科書(1)からの続き
Q(koshix):
15年前に,電子教科書(デジタル教科書)についてのQ&Aを考えました。いよいよデジタル教科書が制度として日本の教育現場に導入されはじめようとしています。15年前のAnswer部分(太字)は,現在文部科学省で導入が計画されているものと一致しているでしょうか。A1〜A21に対して,概ね一致ならば○,部分的一致なら△,概ね異なる場合は×として相違点を示してください。

15年前に考えていたことは以下のとおりである。ChatGPT 4oによる評価は,それぞれのQAの→以下の部分と,相違点として示されている。まあまあそんなものかもしれない。

電子教科書20の質問(2010.02.14 http://twilog.org/koshix)

【導入の意義と目的】
Q1:電子教科書とは何ですか?
 「デジタル化された教科書=ノート」を学校の授業でほぼ常時使うというものです。紙の教科書やノートと鉛筆の代替物として考えています。
→ △(部分的一致)
相違点:
・2025年度からのデジタル教科書は、紙の教科書を完全に代替するものではなく、「紙の教科書を基本」としながら「一部補助的に使用」するものとして導入される。
・「ノート機能」については、標準的な機能としては導入されず、タブレット端末のアプリ等で補完される形となる。


Q2:なぜ電子教科書が必要なのですか?
  社会活動の総体がデジタルベースに移行しつつあるるからです。電子本・電子メディアが多数派になる段階では,学校だけが紙の教科書を使う必然性がありません。
→ ○(概ね一致)
相違点:
・社会のデジタル化を背景にした点は一致。
・文部科学省の説明では「特別支援教育への活用」や「学習データの活用」なども強調されている。


Q3:以前も同じような儲け話がありましたが?
1985パーソナルコンピュータ,1995インターネット,(2005電子黒板),と同様の話は繰り返されています。2015電子教科書も似たようなものですが,3度目の掃除機か。
→ △(部分的一致)
相違点:
・これまでの技術導入(電子黒板など)と同様の議論がある点は一致。
・ただし、2025年度導入は「GIGAスクール構想」に基づくもので、文科省はより長期的な方針としている点が異なる。


【機器整備の問題】
Q4:電子教科書を使うのは誰ですか?
 小学校3年生からの児童および学校教員です。中等・高等教育でも利用可,システムは一般にも販売されて購入可能です。
→ △(部分的一致)
相違点:
・文科省は、小学校5年生から段階的に導入するとしている。
・教員の利用については明確に制度化されておらず、学校ごとの裁量に委ねられる部分が多い。


Q5:本当に無償配布されるのですか?
いいえ。子ども手当ては1人15年間で総額500万円に達するので,それで5年に1度各自購入してもらいます。(小3と中2:機器5年保証含めて1セット5万円,壊したら自分で買い替える)
→ ×(概ね異なる)
相違点:
・文科省は、デジタル教科書を紙の教科書と併用する形で提供し、原則「無償配布」。
・端末はGIGAスクール構想に基づき整備されているが、破損時の補償などは自治体ごとに異なる。


Q6:教員はどうなるのでしょうか?
 私学を含めて5年に1度配布されます。5万円/台×100万台÷5年=100億円/年,新機種配布時に教員研修を12時間(3時間×4回)行います(無料)。機器の使い方だけではなく,免許更新講習の代替のだきあわせみたいなものです。
→ △(部分的一致)
相違点:
・教員向けの端末は、GIGAスクール構想で配布済み。
・研修については、各自治体ごとの対応になり、全国統一的な研修は予定されていない。


【仕様の問題】
Q7:システムの仕様はどうなりますか?
 iPad/Android/MS tabletなどを包括する想定で(ありえないか ^_^;;),電子教科書=ノートの基本ソフト部分を別途共通仕様として定めます。マルチタッチ,Wifi/GPS及び各種物理センサーは必須。バッテリは9時間。毎日自宅で充電してね!
→ △(部分的一致)
相違点:
・現在のデジタル教科書は、iPad/Windowsタブレットが主流だが、OSごとに仕様が統一されているわけではない。
・物理センサーの活用は標準ではない。


Q8:教科書コンテンツは誰がつくりますか?
 教科書会社が作成しepubフォーマットで電子教科書=ノートの基本ソフトの上にのせます。この部分は従来の教科書無償配布と同様の仕組みで実現します。すなわち教科書コンテンツ費用は税金でまかなわれます(高校もね)。
→ ○(概ね一致)
相違点:
・教科書会社が作成する点は一致。
・EPUBフォーマットとは限らず、各社独自フォーマットも利用される。


Q9:教科書以外のソフトやコンテンツは載りますか?
 電子教科書=ノートの基本ソフト仕様は公開されているので教員の自作教材や他の市販教材もそのまま載せられます。アプリケーションはHTML5+javascriptの範囲で実現してね。
→ △(部分的一致)
相違点:
・教員が教材を作成して利用することは可能だが、標準仕様としてHTML5+JavaScriptの枠組みが設けられているわけではない。


Q10:システムのバージョンアップはどうなりますか?
   教室の無線LANネットワーク経由で必要な時に負荷分散しながら実行します。教科書会社から毎年の差分データもくるかも。
→ ○(概ね一致)
相違点:
・基本的にはクラウド経由での更新が行われる。


Q11:ノート部分のデータはどこに保存されますか?
 教科書の横の余白のノーレイヤーに書き込みますが,データは端末ローカルに保存されます。バックアップはTimeMachineみたいに教室単位で保存され,複製・移動復元可能です。つまり,センターに集約しません。
→ ×(概ね異なる)
相違点:
・現在のデジタル教科書はクラウド保存が基本(自治体ごとに異なる)。
・端末ローカル保存のみ、という方式ではない。


【システム運用の問題】
Q12:小学校1年生から使うのですか?
 9歳未満は禁止^_^;;;です。小学校3年から使ってね。1・2年生は,これまでどおり手を使ってください。なお,教員用やグループ活動には小学校1年から使えます。
→ ×(概ね異なる)
相違点:
・2025年の導入は小5から段階的に進められる。


Q13:家でも使えるのですか?
 ランドセルやカバンにいれて毎日持ち運びます(1kg以下)。学校においておくと,管理がたいへんですからね。家でもそのまま使えますので,宿題もでます。
→ ○(概ね一致)
相違点:
・端末は持ち帰り可能な自治体もあるが、学校管理のもとで運用されることが多い。


Q14:壊れたらどうしますか?
 教室や学校に予備機があります。データは教室のサーバに残っていますので,必要部分だけ復元してそのまま使えます。保証に入っていますので,学校に届け出ると交換機種が宅配されます。
→ △(部分的一致)
相違点:
・一部の自治体では予備機の配備があるが、全国的に統一されていない。


【インターフェースの問題】
Q15:ノートを指で入力するんじゃないでしょうね?
 指でもスタイラスでも使えます。細かい入力作業が必要な場合は筆箱?からスタイラスを取り出して使ってくださいね(ここ一番弱点・致命的かも)。
→ ○(概ね一致)
相違点:
・指入力・スタイラス入力の両方に対応している。


Q16:音声入力,文字認識,翻訳はできますか。
 まあ,iPhone程度には実現可能です。カメラ・ビデオ撮影も(ここが微妙),音声記録も可能で,楽器としても使えます。理科実験の測定器としてもね。
→ ○(概ね一致)
相違点:
・音声入力、OCR機能、翻訳機能は一部端末で可能。


Q17:教科ごとに別のソフトの使い方を覚えるのですか?
 基本操作は説明書なしで使えます。操作も統一され,超高速ブラウジングと柔軟なタッチ入力が可能です。標準状態では非常にシンプルな造りになっています。
→ △(部分的一致)
相違点:
・各教科書会社のUIが統一されているわけではなく、一定の操作統一はあるが完全ではない。


【教師の指導の問題】
Q18:教員が使いこなせるでしょうか?
 授業で教科書を使ったりノートを取ったりする部分がおきかわるだけで操作は単純です。教員がアプリケーションの使い方を覚えなければならないということはありません。
→ △(部分的一致)
相違点:
・研修の実施は自治体ごとに異なるため、必ずしも十分とはいえない。


Q19:プリントの配布や宿題のチェックはどうなりますか?
 教室で全員にオンライン配布と回収できます。従来通り赤ペンでチェックしながら作業してそのまま返却できます(ほんとかな,この部分重要)。
→ ○(概ね一致)
相違点:
・クラウド上で課題配布・提出が可能な環境が整いつつある。


【データ管理の問題】
Q20:古い教科書やノートはどうなりますか?
 えーっと,すべて持ち歩けます。わからなくなったら古い教科書やノートを見直してください。
→ △(部分的一致)
相違点:
・教科書の保存期間やアクセス制限がある可能性がある。


Q21:個人情報とか著作権とかどうなりますか?
 すぐにはどうにもなりません。社会の方が変わらないことには。
→ △(部分的一致)
相違点:
・文科省は個人情報・著作権の管理についてガイドラインを定めている。

#なんで20の質問なのに21あるんだろうか?


図:電子教科書のイメージ(DALL-E3によるもの)


2025年2月22日土曜日

電子教科書(1)

twitter13周年からの続き

学習者用のデジタル教科書はすでに,教科書代替教材としてすでに小中学校の英語で100%,算数数学で55%の学校に導入されている。

さらに,次期学習指導要領が実施される2030年度から,デジタル教科書が従来の検定教科書と同等のものとして導入される方向で議論が進んでいる。どういう仕組みでどんなものになるのかがまだよく理解できていない。それに関する自分の過去の記憶。


下図は自分のTwitter投稿数/月の統計である。15年前の2010年2月から3月にかけて一つのピークがあり一日平均7-8件投稿していた。このときTwitterで電子教科書=デジタル教科書の話題盛り上がっていたからだ。このときの論客が,GLOCOMの豊福晋平さんや新潟の片山敏郎さんだ。

インターネットの商用利用がスタートした1990年代の中頃から,研究室の学生さんたちの卒業研究でデジタル教材を作成し始めていた。自分が考えていた電子教科書というのは,小中高校生が一人一台の端末を持って,そこに教科書・教材コンテンツを載せるというものだ。前者の部分はGIGAスクール構想として2019年からスタートしている。後者のデジタル教科書部分の検定教科書化が2030年からというわけだ。

当時,デジタル教科書とよぶか電子教科書とよぶかで議論があったが,ハードウェアとソフトウェアを一体化して考えた自分は後者だった。ところが,多数派はデジタル教科書を支持し,その後,日本デジタル教科書学会やデジタル教科書教材協議会(現在の超教育協会)などが設立された。


図:Twilogの統計画面(2008.8-2025.2)

2010年2月前夜の自分のTwitterはこんな調子だった。
2010年01月11日(月)
SF第7弾:弐千拾五年電子教科書日本全国一律配布電子石板芯端末仕様策定委報告/十歳以上教室常置九時間電源無線歪杯青葉有機燐光表示拾寸多指接触両面撮像光石投射立体集発音超音波探信全球位置磁場三軸加速度赤外線放射温度/音声画像認識栗可応答電子紙挟辞書事典図書蔵名画音盤芸能映画漫画満載
そして議論の結果,自分の中の電子教科書は
電子教科書5つの原則(2010.02.26 http://twilog.org/koshix)

1.子どもが一人一台持って学校の授業や校外の学びで使うもの。
2.教科書や他の教材をマルチメディア拡張して視聴し操作するもの。
3.ワークシートやノートのように記録しながら学びを進めるもの。
4.学習の過程を教師や子どもがネットワークで共有可能であるもの。
5.誰にとっても自然でシンプルで使いやすくてワクワクするもの。
としてまとめられた。


2025年2月21日金曜日

こっき(2)

こっき(1)からの続き

国旗アプリを改良しようと考えた。1ステップ前の国旗に戻れるようにするものだ。最初は,左下の1/4×1/4領域に,前回表示した国旗の小さなイメージを表示させてそこをクリックすると前の表示に戻るようにするものだ。国名は通し番号をつけて右下に移動した。

ChatGPT o3-mini-highにお願いしたところ,何度かのやりとりの後に目的のものはできたにはできたが,国旗が2つも表示されているのは子どもにはわかりにくそうだ。やり直し。

Q(koshix):
国旗表示アプリ
以下のウェブアプリに修正を加えてください。
(1) 各国旗には次の3つの番号を持ちます。(a) アルファベット順の通し番号,(b) アイウエオ順の通し番号,(c) アプリ起動後にその国旗が最初に表示されたときの通し番号
(2) カタカナの国名表示部分を,通し番号:カタカナ国名 の形に修正してください。このときの通し番号は,表示モードに対応したものとします。
(3) 右下に半透明グレーのボタン領域を設定してください。その機能は後で説明します。まずは,(1) (2) を実装した全体コードをお願いします。
なお,修正前のコードは以下のとおりです。

Q(koshix):
ボタン領域を「もどる」というなまえにして,ここをクリックすると選択された領域で表示されている国旗より通し番号がワンステップ小さいものに戻って表示するようにしてください。

これで目的のものはできた。361行のウェブアプリである。やはりどういうロジックにするかを想定しながらプロンプトを考えるのが重要だ。前回は単なる仕様だけで依頼したので,うまく機能しなかったので結構モチャついた371行。


図:kokki.htmlのiPhoneでの実行画面

以下が,修正版のkokki.htmlのソースコードだ。108行目あたりのkazaha.jpgを自分のイメージファイルに変えて,kokki.htmlと同じフォルダに設置して,ブラウザで閲覧すればOKだ。

<!DOCTYPE html>
<html lang="ja">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>かざは の こっき</title>
  <style>
    html, body {
      margin: 0;
      padding: 0;
      background-color: #f0f0f0;
      height: 100%;
      font-family: sans-serif;
    }
    /* トップページ(スタート前) */
    #top-page {
      text-align: center;
      padding: 20px;
    }
    #top-page h1 {
      font-size: 2em;
      margin-bottom: 20px;
    }
    #top-page img {
      width: 437px;
      height: 377px;
      margin-bottom: 20px;
    }
    /* スタートボタン */
    #start-button {
      padding: 12px 24px;
      font-size: 1.5em;
      border: none;
      border-radius: 8px;
      background-color: #007aff;
      color: #fff;
      cursor: pointer;
    }
    /* 国旗表示ボックス */
    #flag-container {
      width: 90vw;
      height: 70vh;
      margin: 5vh auto;
      position: relative;
      background-color: #000;
      border: 5px solid #fff;
      box-shadow: 0 4px 8px rgba(0,0,0,0.5);
      cursor: pointer;
      display: none; /* スタート前は非表示 */
      touch-action: manipulation;
    }
    #flag-container img {
      width: 100%;
      height: 100%;
      object-fit: contain;
      opacity: 0;
      transition: opacity 0.8s ease-in-out;
      position: absolute;
      top: 0;
      left: 0;
    }
    #country-name {
      position: absolute;
      bottom: 10px;
      left: 10px;
      background: rgba(255, 255, 255, 0.7);
      padding: 4px 8px;
      border-radius: 8px;
      font-size: 1.2em;
      z-index: 10;
    }
    /* 設定パネル */
    #control-panel {
      position: absolute;
      top: 10px;
      left: 50%;
      transform: translateX(-50%);
      background: rgba(255,255,255,0.9);
      padding: 8px;
      border-radius: 8px;
      z-index: 10;
      display: flex;
      gap: 10px;
      align-items: center;
    }
    #control-panel select {
      font-size: 1em;
      padding: 4px;
    }
    /* 右下の半透明グレーのボタン領域(もどるボタン) */
    #button-area {
      position: absolute;
      bottom: 10px;
      right: 10px;
      background: rgba(128, 128, 128, 0.5);
      padding: 10px;
      border-radius: 8px;
      z-index: 10;
      cursor: pointer;
      user-select: none;
    }
  </style>
</head>
<body>
  <!-- トップページ(初回表示) -->
  <div id="top-page">
    <h1>かざは の こっき</h1>
    <img src="kazaha.jpg" alt="かざはの顔">
    <br>
    <button id="start-button">スタート</button>
  </div>
  
  <!-- 国旗表示エリア -->
  <div id="flag-container">
    <img id="flag-image" src="" alt="国旗">
    <div id="country-name"></div>
    <div id="control-panel">
      <div>
        <label for="order-select">表示順序:</label>
        <select id="order-select">
          <option value="alphabetical">アルファベット順</option>
          <option value="japanese">アイウエオ順</option>
          <option value="random">ランダム</option>
        </select>
      </div>
      <div>
        <label for="region-select">表示領域:</label>
        <select id="region-select">
          <option value="all">全世界</option>
          <option value="eastAsiaOceania">東アジア〜オセアニア</option>
          <option value="southWestAsia">南〜西アジア</option>
          <option value="europe">ヨーロッパ</option>
          <option value="africa">アフリカ大陸</option>
          <option value="americas">アメリカ大陸</option>
        </select>
      </div>
    </div>
    <!-- 右下の「もどる」ボタン領域 -->
    <div id="button-area">もどる</div>
  </div>

  <!-- Kuroshiro と Kuromoji の読み込み -->
  <script src="https://unpkg.com/kuroshiro@1.1.3/dist/kuroshiro.min.js"></script>
  <script src="https://unpkg.com/kuroshiro-analyzer-kuromoji@1.1.0/dist/kuroshiro-analyzer-kuromoji.min.js"></script>
  
  <script>
    // グローバル変数
    let allCountries = [];
    let countries = [];
    let currentIndex = 0;
    let kuroshiro;
    let randomDisplayCounter = 1; // ランダムモードで初回表示されたときの番号用
    
    // 初期化処理全体をまとめる
    async function initializeApp() {
      // トップページを非表示、国旗エリアを表示
      document.getElementById("top-page").style.display = "none";
      document.getElementById("flag-container").style.display = "block";
      
      // Kuroshiro の初期化
      try {
        kuroshiro = new Kuroshiro();
        await kuroshiro.init(new KuroshiroAnalyzerKuromoji({
          dictPath: 'https://unpkg.com/kuromoji@0.1.2/dict/'
        }));
        console.log("Kuroshiro initialized");
      } catch (error) {
        console.error("Kuroshiro initialization failed:", error);
      }
      
      // 国データの取得
      await fetchCountries();
      // イベントリスナーの設定
      setupEventListeners();
    }
    
    // 国データ取得
    async function fetchCountries() {
      try {
        const response = await fetch("https://restcountries.com/v3.1/all");
        const data = await response.json();
        allCountries = await Promise.all(data.map(async country => {
          const flagUrl = country.flags && country.flags.png ? country.flags.png : "";
          const nameEn = country.name && country.name.common ? country.name.common : "";
          const jpName = (country.translations &&
                          country.translations.jpn &&
                          country.translations.jpn.common) ? country.translations.jpn.common : nameEn;
          let nameKatakana = "";
          try {
            nameKatakana = await kuroshiro.convert(jpName, { to: "katakana", mode: "normal" });
          } catch (err) {
            console.error("Conversion error:", err);
            nameKatakana = jpName;
          }
          return {
            flag: flagUrl,
            name_en: nameEn,
            name_katakana: nameKatakana,
            region: country.region || "",
            subregion: country.subregion || ""
          };
        }));
        // 不要なデータの除外
        allCountries = allCountries.filter(c => c.flag && c.name_en && c.name_katakana);
        
        // 各国旗に対してグローバルな番号を付与
        // (a) アルファベット順の通し番号
        let sortedAlpha = [...allCountries].sort((a, b) => a.name_en.localeCompare(b.name_en));
        sortedAlpha.forEach((country, index) => {
          country.numAlpha = index + 1;
        });
        // (b) アイウエオ順(カタカナ順)の通し番号
        let sortedKatakana = [...allCountries].sort((a, b) => a.name_katakana.localeCompare(b.name_katakana, "ja"));
        sortedKatakana.forEach((country, index) => {
          country.numKatakana = index + 1;
        });
        // (c) ランダムモード用(初回表示時に設定)の番号は未設定状態に
        allCountries.forEach(country => {
          country.numDisplay = null;
        });
        
        // 初期のフィルタ・ソート処理
        filterCountries();
        sortCountries();
        displayCountry();
      } catch (error) {
        console.error("Error fetching countries:", error);
      }
    }
    
    // 表示領域でフィルタ
    function filterCountries() {
      const regionValue = document.getElementById("region-select").value;
      if (regionValue === "all") {
        countries = allCountries.slice();
      } else if (regionValue === "eastAsiaOceania") {
        countries = allCountries.filter(c => 
          (c.region === "Oceania") ||
          (c.region === "Asia" && (c.subregion === "Eastern Asia" || c.subregion === "South-Eastern Asia"))
        );
      } else if (regionValue === "southWestAsia") {
        countries = allCountries.filter(c => 
          c.region === "Asia" && !(c.subregion === "Eastern Asia" || c.subregion === "South-Eastern Asia")
        );
      } else if (regionValue === "europe") {
        countries = allCountries.filter(c => c.region === "Europe");
      } else if (regionValue === "africa") {
        countries = allCountries.filter(c => c.region === "Africa");
      } else if (regionValue === "americas") {
        countries = allCountries.filter(c => c.region === "Americas");
      }
      currentIndex = 0;
    }
    
    // 表示順序でソート
    function sortCountries() {
      const order = document.getElementById("order-select").value;
      if (order === "alphabetical") {
        countries.sort((a, b) => a.name_en.localeCompare(b.name_en));
      } else if (order === "japanese") {
        countries.sort((a, b) => a.name_katakana.localeCompare(b.name_katakana, "ja"));
      } else if (order === "random") {
        // ランダムモードでは Fisher-Yates シャッフルを実施
        for (let i = countries.length - 1; i > 0; i--) {
          const j = Math.floor(Math.random() * (i + 1));
          [countries[i], countries[j]] = [countries[j], countries[i]];
        }
      }
      currentIndex = 0;
    }
    
    // 現在の国を表示
    function displayCountry() {
      if (countries.length === 0) {
        console.error("No countries available for the selected region.");
        document.getElementById("country-name").textContent = "データなし";
        document.getElementById("flag-image").src = "";
        return;
      }
      const currentCountry = countries[currentIndex];
      
      // 表示モードに応じた番号を取得
      const orderMode = document.getElementById("order-select").value;
      let displayNumber;
      if (orderMode === "alphabetical") {
        displayNumber = currentCountry.numAlpha;
      } else if (orderMode === "japanese") {
        displayNumber = currentCountry.numKatakana;
      } else if (orderMode === "random") {
        if (!currentCountry.numDisplay) {  // 初回表示時のみ番号を付与
          currentCountry.numDisplay = randomDisplayCounter++;
        }
        displayNumber = currentCountry.numDisplay;
      }
      
      // 国旗画像の切替演出
      const flagImage = document.getElementById("flag-image");
      flagImage.style.opacity = 0;
      setTimeout(() => {
        flagImage.src = currentCountry.flag;
        // 「通し番号:カタカナ国名」の形式で表示
        document.getElementById("country-name").textContent = displayNumber + ":" + currentCountry.name_katakana;
        flagImage.onload = () => {
          flagImage.style.opacity = 1;
        };
      }, 800);
    }
    
    // イベントリスナーの設定(タッチ対応の場合は touchend を優先)
    function setupEventListeners() {
      const flagContainer = document.getElementById("flag-container");
      
      function nextCountry() {
        currentIndex = (currentIndex + 1) % countries.length;
        displayCountry();
      }
      
      // タッチまたはクリックで次の国を表示
      if ('ontouchstart' in window || navigator.maxTouchPoints) {
        flagContainer.addEventListener("touchend", function(e) {
          nextCountry();
        }, false);
      } else {
        flagContainer.addEventListener("click", function(e) {
          nextCountry();
        }, false);
      }
      
      // 表示順序・表示領域の変更時の再ソート/再表示
      document.getElementById("order-select").addEventListener("change", () => {
        sortCountries();
        displayCountry();
      });
      document.getElementById("region-select").addEventListener("change", () => {
        filterCountries();
        sortCountries();
        displayCountry();
      });
      
      // 「もどる」ボタンのイベント設定
      const buttonArea = document.getElementById("button-area");
      
      // タッチイベントに対応
      buttonArea.addEventListener("touchend", function(e) {
        e.stopPropagation();
        e.preventDefault();  // タッチ操作時のデフォルト動作を防止
        if (countries.length > 0) {
          currentIndex = (currentIndex - 1 + countries.length) % countries.length;
          displayCountry();
        }
      }, false);
      
      // PCなど、タッチ以外のデバイス用のクリックイベントも残す
      buttonArea.addEventListener("click", function(e) {
        e.stopPropagation();
        if (countries.length > 0) {
          currentIndex = (currentIndex - 1 + countries.length) % countries.length;
          displayCountry();
        }
      }, false);
    }
    
    // スタートボタンのイベント設定(pointerup イベントを使用)
    document.getElementById("start-button").addEventListener("pointerup", () => {
      initializeApp();
    });
  </script>
</body>
</html>


2025年2月20日木曜日

こっき(1)

まだ1歳10ヶ月の風葉ちゃんは国旗を覚えるのが得意だ。GGが知らない国の国旗を沢山知っている。ママからのリクエストで国旗アプリを考えることになった。市販のスマホアプリは1-2歳向けではないのだ。要求仕様は次のようなものになる。

(1) 世界の国旗が地域別(または全世界)に表示される。
(2) その下にはカタカナの国名が表示されている。ママだけが読める。 
(3) タップすると順に次の国旗が表示される。国名がわからなければママが解説する。
(4) 表示は,アルファベット順,アイウエオ順,ランダムとする。
(5) 地域は,東アジア・オセアニア,西・南アジア,ヨーロッパ,アフリカ大陸,アメリカ大陸とする。

本物のiPhoneアプリはハードルが高すぎるので,とりあえずWebアプリにしよう。もちろん,高齢者の脳力に頼っていては死ぬまでにできあがらないので,ChatGPT o3-mini-high にお願いするわけだ。自分が入れた一連のプロンプトは以下のとおりである。

Q(koshix):
幼児向けの国旗のウェブアプリを作ってください。
お母さんと子どもが一緒に遊べるものです。
・国旗の画面が大写しになります。
・その画面に国名が小さく表示されます。
・スライドするとつぎの国旗にうつります。
・表示順序をアルファベット順,五十音順,ランダムに設定変更できます。
国連に加盟しているすべての国や地域のフリーのイメージデータに
アクセスして表示できるようにします。

Q(koshix):
国名はカタカナにしてください。
クリックしたら次の国旗に進むようにしてください。それまでは静止です。

Q(koshix):
画面が真っ暗で表示されず,クリックしても進まないのですが。

Q(koshix):
(1) 国旗の表示が画面いっぱいになっているので,もう少し小さめにして余白領域を作ってください。
(2) 表示範囲を,東アジア〜オセアニア・南〜西アジア・ヨーロッパ・アフリカ大陸・アメリカ大陸の5領域および全世界の6つから選択できるようにしてください。
(3) iPhoneにこのhtmlファイルを転送して実行しようとすると,スタート時点でつまづいて進みません。iPhoneでも使えるように対処可能でしょうか。

Q(koshix):
ありがとうございます。機能はほぼ希望通りになりました。しかし,iPhoneでは画面が真っ暗のままで進まずに停まっています。どこかへのアクセスが拒否されているような感じです。どうすればよいでしょうか。

Q(koshix):
iPhoneだけでなんとかしたいので,外部にhttps対応サーバを準備することができないのですが。マウスクリック操作の機能部分ははタッチ操作に対応するようになっていますかね。

Q(koshix):
1.ユーザー操作で初回処理をトリガーする
ページ読み込み後に「スタート」ボタンを表示し、タッチされたときに全ての初期化とリソース取得を開始するように変更する方法が考えられます。これなら、iOS側での自動起動制限を回避できる場合があります。
2.ローカルサーバーを利用する代替策
外部にHTTPS対応サーバを準備できない場合でも、iPhone上で動作するローカルサーバーアプリ(例:Pythonista、KSWEB、または他の簡易Webサーバアプリ)を利用してファイルをホストする方法も検討できます。

これらの場合の具体的な手順を詳細に説明してください。

Q(koshix):
localでウェブサーバを立ち上げ,iphoneでアクセスすることに成功しました。

Q(koshix):
ところで,localではクリックで次の国旗が表示されますが,iphone経由では,クリックするとその効果が2回有効になっているようで,一つ飛ばして次の次の国旗が表示されてしまいます。どうすればいいでしょうか。

Q(koshix):
1の方法をとりたいのですが,元のコードで言うとどの部分の修正になりますか。修正後の全コードを教えてもらったほうが助かります。

Q(koshix):
最初のスタートで次に進むことができなくなりました。

Q(koshix):
ありがとうございます,うまくいきました。
トップ頁に「かざは の こっき」というタイトルをいれて,かざはの顔写真 kazaha.jpg  437x377 ピクセルを表示するように修正できますか。 kazaha.jpg はkokki.html と同じフォルダにあります。


図:世界の国旗(外務省から編集して引用)

pythonでローカルのウェブサーバを立ち上げ,ngrokでトンネルを設定すると,外部からローカルウェブサーバのコンテンツにアクセスすることができる。そこで,kokki.html(296行)とkazaha.jpgを置いたディレクトリでローカルウェブサーバを立ち上げておけば,ngrokが指定するURLでiPhoneからこの国旗Webアプリが使えるようになった。
python3 -m http.server 8000
ngrok http 8000
https://zzzzzzzzzz.ngrok.io/kokki.html 
問題は,ngrokを無料で使っている限りこのURLが永続的ではないことだ。sakuraインターネットに眠らせてあるWebサイトを起すべきだろうか。ChatGPTを使えば一日一ウェブアプリを公開することができる。

(付)http.server ファイルの中身
import http.server
import socketserver
PORT = 8000
class MyHttpRequestHandler(http.server.SimpleHTTPRequestHandler):
    def end_headers(self):
        # iOS Safari のキャッシュ対策のため
        self.send_header("Cache-Control", "no-store, no-cache, must-revalidate")        http.server.SimpleHTTPRequestHandler.end_headers(self)
Handler = MyHttpRequestHandler
with socketserver.TCPServer(("", PORT), Handler) as httpd:
    print("Serving at port", PORT)
    httpd.serve_forever()

2025年2月19日水曜日

Typst(2)

Typst(1)からの続き

自分のLaTeX利用ではTikZによる作図が大きな割合を占めている。TypstがLaTeXの代替の組版処理(文書整形)ツールとして使えるためには,TikZに相当する図形描画機能が必須だ。

調べてみると,CeTZというツールがある。CeTZ-plotもその仲間だ。関数やベジェ曲線にも対応しているので,TikZでこれまで作成してきたものは概ね再現できそうだ。具体例として,115 Scientific Diagrams というページに,物理や化学で用いられる図が,CeTZで74例,TikZで109例,示されている。

まだ慣れないからかもしれないが,TikZの方が使いやすいと思う。115 Scientific Diagramの同じ図で比較しても,CeTZの方が1TikZに比べて1.5倍程度の行数が必要だ。まあ,ないよりましなのだ。


図:CeTZによる凸関数の例(115 Scientific Diagrams から引用)


[3]115 Scienfitic Diagrams(Janosh Riebesell)

2025年2月18日火曜日

Typst(1)

奥村さんが Typst β版の新バージョンが出たことを話題にしていた。聞き覚えがあるような気もするが,早速インストールして試してみよう,というかこれは何をするものだ?

Typstは2023年に生まれた組版処理システム(PCで整形されたきれいな文書をつくるもの)だ。同種のものとして,ドナルド・クヌース(1938-)が1978年に開発したTeXや,レスリー・ランポート(1941-)がこれに続いて1984年に作ったLaTeXがある。まあ,Wordだってその仲間だ。咲子がLaTeXならば風葉がTypstだ。軽量マークアップ言語のMarkdown(2004)に数式表現が加わっている。同工のものとして日本発のSATySFy(2021)がある。

さて,ローカル版はhomebrewで簡単にインストールできる。sample.typ ファイルに対して, typst c sample.typ とすれば,sample.pdf が得られる。しかも,LaTeXよりずっと速い。typst w sample.typ とすれば,ソースコードを修正しながらこれが反映した結果のpdfファイルを確認できる。Typst.appにはWeb版もあって,登録すれば無料で利用できる。Sing In したところ,メールアドレスは登録済みだったので,昔いちど試してみたのかもしれない。もう忘れている。

LaTeXとTypstのコンバータがあれば便利だろうと,OpenAI o3-mini-high にやらせてみたところ,すぐにできたが,入力したtexファイルに問題があって,うまくいかなかった。そうこうしているうちに,ファイルコンバータのpandoc にはこの変換が組み込まれている(逆方向はダメ)ことがわかり,確かにうまくいった(\Big は\big に直す必要があった)。


図:Typst のアイコン(Typstのホームページから引用)

Q(koshix):
日本語と数式と図を含んだ組版システムとして,LaTeX(昔から)とTypst(最近)があります。この両者の特徴を比較して,どちらがお薦めかを教えてください。

A(Perplexity Pro):
LaTeXとTypstは、両者とも日本語、数式、図を含んだ文書の組版に適したシステムですが、それぞれに特徴があります。以下に両者を比較し、どちらがおすすめかを検討します。

LaTeXの特徴
長所:
・長年の実績があり、学術界で広く使用されている
・複雑な数式や特殊文字を正確に表現できる
・異なる要素のスタイルを厳密かつ一貫して制御できる
・すべてのOSと互換性がある
・数式や図表の自由な配置編集が可能
・安定性が高く、バグが少ない
短所:
・環境構築が複雑
・エラーメッセージが不親切で、デバッグが困難
・初心者には扱いづらい

Typstの特徴
長所:
・文法がわかりやすく、特に数式の記述が直感的
・エラーメッセージが親切で理解しやすい
・環境構築が簡単
・処理速度が非常に速い
・レイアウトの調整が容易
・LaTeXからの移行がしやすい
短所:
・比較的新しいシステムのため、LaTeXほどの実績がない
・英語のドキュメントしかない

おすすめ
どちらがおすすめかは、ユーザーの状況や目的によって異なります。
LaTeXをおすすめする場合:
・学術論文を執筆し、広く受け入れられているフォーマットが必要な場合
・複雑な数式や特殊な組版が必要な場合
・長期的なサポートや豊富なリソースが必要な場合
Typstをおすすめする場合:
・迅速な文書作成や編集が必要な場合
・環境構築の手間を省きたい場合
・より直感的な文法を好む場合
・処理速度を重視する場合

結論として、学術界での実績や豊富なリソースを重視するならLaTeXが、使いやすさや処理速度を重視するならTypstがおすすめです。ただし、Typstは比較的新しいシステムなので、今後の発展や学術界での受け入れ状況を注視する必要があります。
[1]Typst.app 公式ページ
[3]Typst入門(奥村晴彦)
[4]Typstの使い方(KumaROOT)
[5]Typstのはじめかた(monaqa)
[6]組版処理システムTypstの紹介(樫村博基)
[7]便利パッケージと使用例の紹介(Qiita,key_271)

2025年2月17日月曜日

失敗の本質

1月31日の日経朝刊,日経コメンテーターの中山淳史による「失敗の本質」野中郁次郎氏の遺産 野性こそ創造の源泉がおもしろかった。中山による生前の野中への取材をまとめたものだ。一橋大学名誉教授の野中郁次郎(1935-2025)は,カリフォルニア大学バークレー校でドクターを取得し,防衛大学校に所属しているときに「失敗の本質 日本軍の組織論的研究」を書いた。

脳トレのために,自力で要約してみよう。

第2次大戦における日本軍の様々な失敗の場面を分析したのが「失敗の本質」だ。その観点から日本の「失われた30年」を考える視点を尋ねたのが野中への取材の要目だった。日本の低迷の原因は普通「雇用,設備,債務の3つの過剰」だとされるが,野中は「プランニング(計画),アナリシス(分析),コンプライアンス(法令順守)の3つの過剰」だと強調した。

わかるわかる。PDCAだよ。国立大学法人化後の中期目標計画と認証評価制度のことだよ。そして今再び,中教審の大学分科会の中間報告からニュースのトップに取上げられたのがこれだ。あーぁ・・・。また屋上屋を重ねるのか。
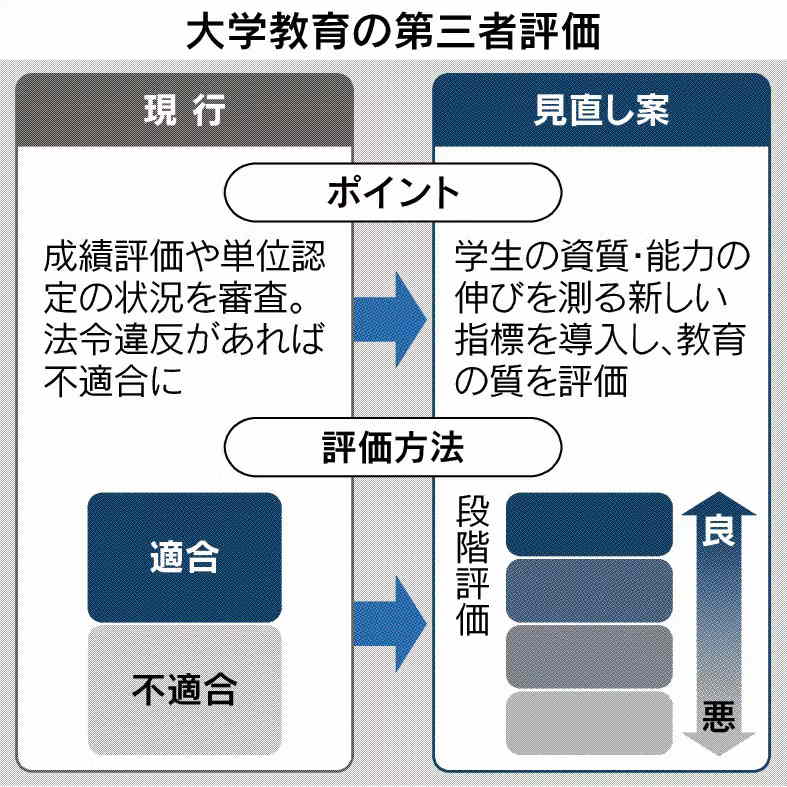
文部科学省は大学の運営を第三者が審査する「認証評価制度」を見直す。在学中の学生の成長具合など、教育の質を測る指標をつくり、複数段階で評価する。受験生らが偏差値やイメージではなく、教育内容を比較して進学先を選べるようにする。大学間の切磋琢磨(せっさたくま)を促し、大学教育全体の質向上にもつなげる。

図1:大学教育の第三者評価(日経新聞2025.1.29より引用)


話を戻そう。野中は,日本のPDCA(計画・実行・評価・改善)が「PdCa」になってしまい肝心の行動と改善がおろそかになっていることを指摘する。計画や分析やルールづくりが行き過ぎ,自己目的化し,経営(研究教育)の活力を損なってしまうというわけだ。

これに替わるもの,提案したのがSECIモデルだ。それは組織における個人の暗黙値を集団で共有してイノベーションを推進するため,知識の生成と共有のプロセスをモデル化したものだ。徹底した対話で暗黙知を言葉や論理による形式知に変換し,最終的には集団で獲得した知の実践を通じて個人の暗黙知をもう一段高めていくものだ。

すなわち,SECI = 共同化(Socialization),表出化(Externalization),連結化(Combination),内面化(Internalization)というわけだ。


図2:野中郁次郎のSECIモデル(日経新聞2025.1.31から引用)

[1]大学の教育評価と成果の可視化(齊藤貴浩・林隆之)

2025年2月16日日曜日

ChatGPT o3-mini(3)

ChatGPT o3-mini(2)からの続き

東京理科大の数学の入試問題が話題になっていた。出題ミスだとかなんとか。その真偽はわからないのだけれど,この問題の最終段階で必要となる式を眺めると,ちょっと自分には解けなさそうだった。なさけない。以下の左辺から右辺を導くのだ。

$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{1}{2} + \dfrac{2\pi}{\sqrt{17}} \tan {\dfrac{\sqrt{17} \ \pi}{2}}$ 

Mathematicaでは,238μsで正解が得られる。ChatGPT o3-mini-highでは,やたら推論時間がかかってしまい途中では誤りもみられる。便利なようだけれど使い方は要注意。 
Q(koshix):
次の級数を求めてください。 Σ_{n=2}^∞ 2/(n^2+3n-2)

A(ChatGPT o3-mini-high):
(31秒かけて推論)
(導出過程省略)
【結論】
したがって,この級数の和は,
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{\sqrt{17}}{2}\Bigl[ \psi\Bigl(\dfrac{7+\sqrt{17}}{2}\Bigr) - \psi\Bigl( \dfrac{7-\sqrt{17}}{2}\Bigr) \Bigr] $ 
【補足】
・ここで用いたディガンマ関数$\psi(x)$は,$\psi(x) = \frac{d}{dx} \ln \Gamma(x)$と定義される特殊関数です。
・回答はこれ以上初等関数だけで簡単な形にまとめることは難しく,この形で示すのが一般的です。

このように、部分分数分解とディガンマ関数の性質を用いることで、与えられた級数を閉じた形で表すことができました。


Q(koshix):
ディガンマ関数を用いずに,高等学校数学の範囲に登場する関数で表現してください。

A(ChatGPT o3-mini-high):
(117秒かけて推論)
(導出過程省略)
【まとめ・最終回答】
部分分数分解と(望遠的な)和の評価により、特殊関数を使わず初等関数だけで表すと,
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{1}{\sqrt{17}} \ln {\dfrac{5+ \ \sqrt{17} }{5-\sqrt{17}}}  $ 

【補足】
・導出の途中で「拡張調和数」やディガンマ関数を用いる方法もありますが,最終結果は対数と平方根のみで表されています。
・(実際の解析では、各項の和を適切に並べ替え・打ち消すことでこの形が得られることが確認できます。)

以上が、特殊関数を用いず高等学校数学レベルの初等関数のみで表現した解答です。


Q(koshix):
その結果は間違ってますね。Tan が出てくるはずですが。

A(ChatGPT o3-mini-high):
(74秒かけて推論)
(導出過程省略)
【最終回答】
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{2\pi}{\sqrt{17}} \tan {\dfrac{\pi \ \sqrt{17} }{2}} + \dfrac{1}{2} $ 
(解説省略)

2025年2月15日土曜日

ChatGPT o3-mini(2)

ChatGPT o3-mini(1)&「は、」からの続き

ChatGPT o3-mini の実力をなかなか試せていない。そこで,係助詞「は」直後の読点問題に挑戦させてみた。ChatGPT o3-mini-highで試したところ,正しいコードが一発で得られた。「、」に「,」を追加する修正も楽々。ただし,自分の環境設定に問題があった。o3-mini-highのアドバイスをもらいながら修正を試みる。

(1)  source ./myenv/bin/activate でvenv環境に移行する。
(2)  python3 -m pip install mecab-python3 でmecab-python3 をインストールする。
(3)  pip install --upgrade pip で pipのバージョンをあげた。(23.1.2 → 25.0)
(4)  python3 jta.py text.txt で /usr/local/etc/mecabrc が見つからないとのエラー。
(5)  sudo mkdir /usr/local/etc で etcディレクトリを作成。
(6)  sudo ln -s /opt/homebrew/etc/mecabrc  /usr/local/etc/mecabrc でシンボリックリンクを作成。
(7) (venv) python -m jta text.txt で実行できた(データはtext.txtに入っている)。
(8) 自分のブログ記事のいくつかを入れてコマンドラインで実行した結果の例:

=== 全体の統計 ===
句点「。」の数:  72
読点(「、」と「,」)の数:  66
一文あたりの平均読点数: 0.92

=== 係助詞「は」の統計 ===
係助詞「は」の出現数:  51
直後に読点がくる確率: 0.16

=== 係助詞「は」の直後に読点がある文の統計 ===
文数:  8
平均文字数: 137.62
平均読点数: 1.38

=== 係助詞「は」の直後に読点がない文の統計 ===
文数:  32
平均文字数: 38.19
平均読点数: 0.91

思ったより,自分は「は,」を多用していなかった。傾向も原論文と一致している。o3-miniに任せればコードはスイスイとできるとはいうものの,やはり一定のプログラム作成の知識は必要だ。その上,自分の知識は継ぎ接ぎ穴だらけであり,いきあたりばったりのアドホックな対応でごまかしているところに問題がある。

Q(koshix):
日本語のテキストの解析プログラムをつくりたいです。
テキストがファイルで与えられたとき,これを形態素解析して,
係助詞の「は」がわかるようにします。
(1) 句点と読点の数および,一文あたりの平均読点数を求める。
(2) 係助詞「は」の出現数とその直後に読点がくる確率を求める。
(3) 係助詞「は」の直後に読点がある場合とない場合について,
これを含む文の平均文字数と平均読点数を求める。
これらの機能を持つ日本語解析プログラムを作ってください。

A(ChatGPT o3-mini-high):
以下は、Python と形態素解析ライブラリ MeCab を用いて、指定された3つの解析機能を実現するサンプルプログラムの例です。

以下のコードでは、
・ファイルからテキストを読み込み、
・全体での句点(「。」)と読点(「、」)の出現数および一文あたりの読点数を求め、
・MeCab による形態素解析で「は」が係助詞(形態素情報で「助詞,係助詞」)として出現している場合をカウントし、その直後のトークンが読点(「、」)であるかどうかをチェックし、
・さらに「は」の直後に読点がある場合とない場合で、その文(=句点で区切った文)の文字数と読点数の平均を算出しています。

なお、このプログラムを実行するには、Python 用の MeCab ライブラリ(例:mecab-python3)がインストールされている必要があります。
以下、コードの全体像とともに、各ステップの処理内容についてコメントで説明しています。
(以下略)

Q(koshix):
以下のプログラムの読点を,「、」と「,」の両方に同時に対応できるように修正してください。(先ほどのコードを貼り付ける)

A(ChatGPT o3-mini-high):
(以下は出力されたコードのみで解説を省く,このコードを jta.py とする。)

#!/usr/bin/env python
# -*- coding: utf-8 -*-

"""
日本語テキスト解析プログラム

【機能】
(1) ファイル内のテキスト全体について,
    ・句点「。」と読点「、」および「,」の出現数
    ・一文あたりの平均読点数
    を求める。

(2) MeCab を用いて形態素解析を行い,
    ・係助詞「は」の出現数
    ・その直後に読点がくる確率
    を求める。

(3) 係助詞「は」の直後に読点がある場合とない場合で,
    ・その文の平均文字数
    ・その文の平均読点数
    を求める。
    
※実行例: python japanese_text_analyzer.py input.txt
"""

import MeCab
import argparse

def analyze_text(text):
    # (1) 句点と読点の総数、及び一文あたりの読点数
    total_period = text.count("。")
    # 読点は「、」と「,」の両方に対応
    total_comma = text.count("、") + text.count(",")
    
    # 文章を「。」で分割して文単位にする(文末の句点を補完)
    sentences = []
    for s in text.split("。"):
        s = s.strip()
        if s:
            sentences.append(s + "。")
    num_sentences = len(sentences)
    avg_comma_per_sentence = total_comma / num_sentences if num_sentences > 0 else 0

    # (2) および (3) の解析用に、形態素解析器を初期化
    tagger = MeCab.Tagger()
    
    # 係助詞「は」についての統計
    total_ha_occurrences = 0     # 「は」の出現回数(係助詞として)
    ha_followed_by_comma = 0       # 「は」の直後に読点がある回数
    
    # (3) 用の文ごとの集計
    groupA_sentences = []  # 「は」の直後に読点がある場合を含む文
    groupB_sentences = []  # 「は」の直後に読点がない場合を含む文

    # 各文ごとに形態素解析を実施して処理する
    for sentence in sentences:
        # MeCab で形態素解析(各文を対象)
        node = tagger.parseToNode(sentence)
        tokens = []
        while node:
            # BOS/EOS ノードは除外
            if node.stat in (MeCab.MECAB_BOS_NODE, MeCab.MECAB_EOS_NODE):
                node = node.next
                continue
            # node.feature は「品詞,品詞細分類1,品詞細分類2,品詞細分類3,活用形,活用型,原形,読み,発音」などの情報
            features = node.feature.split(",")
            pos = features[0]               # 例:"助詞"
            pos_detail1 = features[1]       # 例:"係助詞"(係助詞ならこの値)
            # 原形は features[6] だが、情報がない場合もあるので、surface を利用する
            base = features[6] if len(features) > 6 else node.surface
            tokens.append({
                'surface': node.surface,
                'pos': pos,
                'pos_detail1': pos_detail1,
                'base': base
            })
            node = node.next

        # 各文中の「は」に関して、直後のトークンが読点「、」または「,」かどうかをチェック
        sentence_has_ha_followed_comma = False
        sentence_has_ha_not_followed_comma = False
        
        for i, token in enumerate(tokens):
            # 係助詞としての「は」を対象にする
            if token['surface'] == "は" and token['pos'] == "助詞" and token['pos_detail1'] == "係助詞":
                total_ha_occurrences += 1
                # 直後のトークンが存在するかどうかをチェック
                if i + 1 < len(tokens):
                    next_token = tokens[i + 1]
                    if next_token['surface'] in ("、", ","):
                        ha_followed_by_comma += 1
                        sentence_has_ha_followed_comma = True
                    else:
                        sentence_has_ha_not_followed_comma = True
                else:
                    # 直後にトークンがなければ「読点なし」と判断
                    sentence_has_ha_not_followed_comma = True

        # (3) の集計対象として文をグループ分け(※文中に複数の「は」がある場合,
        #  直後に読点がある場合とない場合の両方に該当する可能性があります)
        if sentence_has_ha_followed_comma:
            groupA_sentences.append(sentence)
        if sentence_has_ha_not_followed_comma:
            groupB_sentences.append(sentence)

    # (2) 「は」の直後に読点が来る確率
    prob_ha_comma = ha_followed_by_comma / total_ha_occurrences if total_ha_occurrences > 0 else 0

    # (3) グループごとの文の平均文字数と平均読点数を計算する関数
    def average_metrics(sent_list):
        total_chars = 0
        total_commas_in_sent = 0
        for s in sent_list:
            total_chars += len(s)
            total_commas_in_sent += s.count("、") + s.count(",")
        count = len(sent_list)
        if count == 0:
            return (0, 0)
        return (total_chars / count, total_commas_in_sent / count)
    
    avg_len_groupA, avg_comma_groupA = average_metrics(groupA_sentences)
    avg_len_groupB, avg_comma_groupB = average_metrics(groupB_sentences)
    
    # 結果の出力
    print("=== 全体の統計 ===")
    print("句点「。」の数: ", total_period)
    print("読点(「、」と「,」)の数: ", total_comma)
    print("一文あたりの平均読点数: {:.2f}".format(avg_comma_per_sentence))
    print("")
    
    print("=== 係助詞「は」の統計 ===")
    print("係助詞「は」の出現数: ", total_ha_occurrences)
    print("直後に読点がくる確率: {:.2f}".format(prob_ha_comma))
    print("")
    
    print("=== 係助詞「は」の直後に読点がある文の統計 ===")
    print("文数: ", len(groupA_sentences))
    print("平均文字数: {:.2f}".format(avg_len_groupA))
    print("平均読点数: {:.2f}".format(avg_comma_groupA))
    print("")
    
    print("=== 係助詞「は」の直後に読点がない文の統計 ===")
    print("文数: ", len(groupB_sentences))
    print("平均文字数: {:.2f}".format(avg_len_groupB))
    print("平均読点数: {:.2f}".format(avg_comma_groupB))

def main():
    # コマンドライン引数で対象のファイルを指定
    parser = argparse.ArgumentParser(description="日本語テキスト解析プログラム")
    parser.add_argument("file", help="解析対象のテキストファイルパス")
    args = parser.parse_args()
    
    # ファイルの読み込み(UTF-8 エンコード前提)
    try:
        with open(args.file, "r", encoding="utf-8") as f:
            text = f.read()
    except Exception as e:
        print("ファイルの読み込みに失敗しました:", e)
        return
    
    analyze_text(text)

if __name__ == "__main__":
    main()

[1]OpenAI o3-mini (OpenAI)