2025年2月21日金曜日

こっき(2)

こっき(1)からの続き

国旗アプリを改良しようと考えた。1ステップ前の国旗に戻れるようにするものだ。最初は,左下の1/4×1/4領域に,前回表示した国旗の小さなイメージを表示させてそこをクリックすると前の表示に戻るようにするものだ。国名は通し番号をつけて右下に移動した。

ChatGPT o3-mini-highにお願いしたところ,何度かのやりとりの後に目的のものはできたにはできたが,国旗が2つも表示されているのは子どもにはわかりにくそうだ。やり直し。

Q(koshix):
国旗表示アプリ
以下のウェブアプリに修正を加えてください。
(1) 各国旗には次の3つの番号を持ちます。(a) アルファベット順の通し番号,(b) アイウエオ順の通し番号,(c) アプリ起動後にその国旗が最初に表示されたときの通し番号
(2) カタカナの国名表示部分を,通し番号:カタカナ国名 の形に修正してください。このときの通し番号は,表示モードに対応したものとします。
(3) 右下に半透明グレーのボタン領域を設定してください。その機能は後で説明します。まずは,(1) (2) を実装した全体コードをお願いします。
なお,修正前のコードは以下のとおりです。

Q(koshix):
ボタン領域を「もどる」というなまえにして,ここをクリックすると選択された領域で表示されている国旗より通し番号がワンステップ小さいものに戻って表示するようにしてください。

これで目的のものはできた。361行のウェブアプリである。やはりどういうロジックにするかを想定しながらプロンプトを考えるのが重要だ。前回は単なる仕様だけで依頼したので,うまく機能しなかったので結構モチャついた371行。


図:kokki.htmlのiPhoneでの実行画面

以下が,修正版のkokki.htmlのソースコードだ。108行目あたりのkazaha.jpgを自分のイメージファイルに変えて,kokki.htmlと同じフォルダに設置して,ブラウザで閲覧すればOKだ。

<!DOCTYPE html>
<html lang="ja">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>かざは の こっき</title>
  <style>
    html, body {
      margin: 0;
      padding: 0;
      background-color: #f0f0f0;
      height: 100%;
      font-family: sans-serif;
    }
    /* トップページ(スタート前) */
    #top-page {
      text-align: center;
      padding: 20px;
    }
    #top-page h1 {
      font-size: 2em;
      margin-bottom: 20px;
    }
    #top-page img {
      width: 437px;
      height: 377px;
      margin-bottom: 20px;
    }
    /* スタートボタン */
    #start-button {
      padding: 12px 24px;
      font-size: 1.5em;
      border: none;
      border-radius: 8px;
      background-color: #007aff;
      color: #fff;
      cursor: pointer;
    }
    /* 国旗表示ボックス */
    #flag-container {
      width: 90vw;
      height: 70vh;
      margin: 5vh auto;
      position: relative;
      background-color: #000;
      border: 5px solid #fff;
      box-shadow: 0 4px 8px rgba(0,0,0,0.5);
      cursor: pointer;
      display: none; /* スタート前は非表示 */
      touch-action: manipulation;
    }
    #flag-container img {
      width: 100%;
      height: 100%;
      object-fit: contain;
      opacity: 0;
      transition: opacity 0.8s ease-in-out;
      position: absolute;
      top: 0;
      left: 0;
    }
    #country-name {
      position: absolute;
      bottom: 10px;
      left: 10px;
      background: rgba(255, 255, 255, 0.7);
      padding: 4px 8px;
      border-radius: 8px;
      font-size: 1.2em;
      z-index: 10;
    }
    /* 設定パネル */
    #control-panel {
      position: absolute;
      top: 10px;
      left: 50%;
      transform: translateX(-50%);
      background: rgba(255,255,255,0.9);
      padding: 8px;
      border-radius: 8px;
      z-index: 10;
      display: flex;
      gap: 10px;
      align-items: center;
    }
    #control-panel select {
      font-size: 1em;
      padding: 4px;
    }
    /* 右下の半透明グレーのボタン領域(もどるボタン) */
    #button-area {
      position: absolute;
      bottom: 10px;
      right: 10px;
      background: rgba(128, 128, 128, 0.5);
      padding: 10px;
      border-radius: 8px;
      z-index: 10;
      cursor: pointer;
      user-select: none;
    }
  </style>
</head>
<body>
  <!-- トップページ(初回表示) -->
  <div id="top-page">
    <h1>かざは の こっき</h1>
    <img src="kazaha.jpg" alt="かざはの顔">
    <br>
    <button id="start-button">スタート</button>
  </div>
  
  <!-- 国旗表示エリア -->
  <div id="flag-container">
    <img id="flag-image" src="" alt="国旗">
    <div id="country-name"></div>
    <div id="control-panel">
      <div>
        <label for="order-select">表示順序:</label>
        <select id="order-select">
          <option value="alphabetical">アルファベット順</option>
          <option value="japanese">アイウエオ順</option>
          <option value="random">ランダム</option>
        </select>
      </div>
      <div>
        <label for="region-select">表示領域:</label>
        <select id="region-select">
          <option value="all">全世界</option>
          <option value="eastAsiaOceania">東アジア〜オセアニア</option>
          <option value="southWestAsia">南〜西アジア</option>
          <option value="europe">ヨーロッパ</option>
          <option value="africa">アフリカ大陸</option>
          <option value="americas">アメリカ大陸</option>
        </select>
      </div>
    </div>
    <!-- 右下の「もどる」ボタン領域 -->
    <div id="button-area">もどる</div>
  </div>

  <!-- Kuroshiro と Kuromoji の読み込み -->
  <script src="https://unpkg.com/kuroshiro@1.1.3/dist/kuroshiro.min.js"></script>
  <script src="https://unpkg.com/kuroshiro-analyzer-kuromoji@1.1.0/dist/kuroshiro-analyzer-kuromoji.min.js"></script>
  
  <script>
    // グローバル変数
    let allCountries = [];
    let countries = [];
    let currentIndex = 0;
    let kuroshiro;
    let randomDisplayCounter = 1; // ランダムモードで初回表示されたときの番号用
    
    // 初期化処理全体をまとめる
    async function initializeApp() {
      // トップページを非表示、国旗エリアを表示
      document.getElementById("top-page").style.display = "none";
      document.getElementById("flag-container").style.display = "block";
      
      // Kuroshiro の初期化
      try {
        kuroshiro = new Kuroshiro();
        await kuroshiro.init(new KuroshiroAnalyzerKuromoji({
          dictPath: 'https://unpkg.com/kuromoji@0.1.2/dict/'
        }));
        console.log("Kuroshiro initialized");
      } catch (error) {
        console.error("Kuroshiro initialization failed:", error);
      }
      
      // 国データの取得
      await fetchCountries();
      // イベントリスナーの設定
      setupEventListeners();
    }
    
    // 国データ取得
    async function fetchCountries() {
      try {
        const response = await fetch("https://restcountries.com/v3.1/all");
        const data = await response.json();
        allCountries = await Promise.all(data.map(async country => {
          const flagUrl = country.flags && country.flags.png ? country.flags.png : "";
          const nameEn = country.name && country.name.common ? country.name.common : "";
          const jpName = (country.translations &&
                          country.translations.jpn &&
                          country.translations.jpn.common) ? country.translations.jpn.common : nameEn;
          let nameKatakana = "";
          try {
            nameKatakana = await kuroshiro.convert(jpName, { to: "katakana", mode: "normal" });
          } catch (err) {
            console.error("Conversion error:", err);
            nameKatakana = jpName;
          }
          return {
            flag: flagUrl,
            name_en: nameEn,
            name_katakana: nameKatakana,
            region: country.region || "",
            subregion: country.subregion || ""
          };
        }));
        // 不要なデータの除外
        allCountries = allCountries.filter(c => c.flag && c.name_en && c.name_katakana);
        
        // 各国旗に対してグローバルな番号を付与
        // (a) アルファベット順の通し番号
        let sortedAlpha = [...allCountries].sort((a, b) => a.name_en.localeCompare(b.name_en));
        sortedAlpha.forEach((country, index) => {
          country.numAlpha = index + 1;
        });
        // (b) アイウエオ順(カタカナ順)の通し番号
        let sortedKatakana = [...allCountries].sort((a, b) => a.name_katakana.localeCompare(b.name_katakana, "ja"));
        sortedKatakana.forEach((country, index) => {
          country.numKatakana = index + 1;
        });
        // (c) ランダムモード用(初回表示時に設定)の番号は未設定状態に
        allCountries.forEach(country => {
          country.numDisplay = null;
        });
        
        // 初期のフィルタ・ソート処理
        filterCountries();
        sortCountries();
        displayCountry();
      } catch (error) {
        console.error("Error fetching countries:", error);
      }
    }
    
    // 表示領域でフィルタ
    function filterCountries() {
      const regionValue = document.getElementById("region-select").value;
      if (regionValue === "all") {
        countries = allCountries.slice();
      } else if (regionValue === "eastAsiaOceania") {
        countries = allCountries.filter(c => 
          (c.region === "Oceania") ||
          (c.region === "Asia" && (c.subregion === "Eastern Asia" || c.subregion === "South-Eastern Asia"))
        );
      } else if (regionValue === "southWestAsia") {
        countries = allCountries.filter(c => 
          c.region === "Asia" && !(c.subregion === "Eastern Asia" || c.subregion === "South-Eastern Asia")
        );
      } else if (regionValue === "europe") {
        countries = allCountries.filter(c => c.region === "Europe");
      } else if (regionValue === "africa") {
        countries = allCountries.filter(c => c.region === "Africa");
      } else if (regionValue === "americas") {
        countries = allCountries.filter(c => c.region === "Americas");
      }
      currentIndex = 0;
    }
    
    // 表示順序でソート
    function sortCountries() {
      const order = document.getElementById("order-select").value;
      if (order === "alphabetical") {
        countries.sort((a, b) => a.name_en.localeCompare(b.name_en));
      } else if (order === "japanese") {
        countries.sort((a, b) => a.name_katakana.localeCompare(b.name_katakana, "ja"));
      } else if (order === "random") {
        // ランダムモードでは Fisher-Yates シャッフルを実施
        for (let i = countries.length - 1; i > 0; i--) {
          const j = Math.floor(Math.random() * (i + 1));
          [countries[i], countries[j]] = [countries[j], countries[i]];
        }
      }
      currentIndex = 0;
    }
    
    // 現在の国を表示
    function displayCountry() {
      if (countries.length === 0) {
        console.error("No countries available for the selected region.");
        document.getElementById("country-name").textContent = "データなし";
        document.getElementById("flag-image").src = "";
        return;
      }
      const currentCountry = countries[currentIndex];
      
      // 表示モードに応じた番号を取得
      const orderMode = document.getElementById("order-select").value;
      let displayNumber;
      if (orderMode === "alphabetical") {
        displayNumber = currentCountry.numAlpha;
      } else if (orderMode === "japanese") {
        displayNumber = currentCountry.numKatakana;
      } else if (orderMode === "random") {
        if (!currentCountry.numDisplay) {  // 初回表示時のみ番号を付与
          currentCountry.numDisplay = randomDisplayCounter++;
        }
        displayNumber = currentCountry.numDisplay;
      }
      
      // 国旗画像の切替演出
      const flagImage = document.getElementById("flag-image");
      flagImage.style.opacity = 0;
      setTimeout(() => {
        flagImage.src = currentCountry.flag;
        // 「通し番号:カタカナ国名」の形式で表示
        document.getElementById("country-name").textContent = displayNumber + ":" + currentCountry.name_katakana;
        flagImage.onload = () => {
          flagImage.style.opacity = 1;
        };
      }, 800);
    }
    
    // イベントリスナーの設定(タッチ対応の場合は touchend を優先)
    function setupEventListeners() {
      const flagContainer = document.getElementById("flag-container");
      
      function nextCountry() {
        currentIndex = (currentIndex + 1) % countries.length;
        displayCountry();
      }
      
      // タッチまたはクリックで次の国を表示
      if ('ontouchstart' in window || navigator.maxTouchPoints) {
        flagContainer.addEventListener("touchend", function(e) {
          nextCountry();
        }, false);
      } else {
        flagContainer.addEventListener("click", function(e) {
          nextCountry();
        }, false);
      }
      
      // 表示順序・表示領域の変更時の再ソート/再表示
      document.getElementById("order-select").addEventListener("change", () => {
        sortCountries();
        displayCountry();
      });
      document.getElementById("region-select").addEventListener("change", () => {
        filterCountries();
        sortCountries();
        displayCountry();
      });
      
      // 「もどる」ボタンのイベント設定
      const buttonArea = document.getElementById("button-area");
      
      // タッチイベントに対応
      buttonArea.addEventListener("touchend", function(e) {
        e.stopPropagation();
        e.preventDefault();  // タッチ操作時のデフォルト動作を防止
        if (countries.length > 0) {
          currentIndex = (currentIndex - 1 + countries.length) % countries.length;
          displayCountry();
        }
      }, false);
      
      // PCなど、タッチ以外のデバイス用のクリックイベントも残す
      buttonArea.addEventListener("click", function(e) {
        e.stopPropagation();
        if (countries.length > 0) {
          currentIndex = (currentIndex - 1 + countries.length) % countries.length;
          displayCountry();
        }
      }, false);
    }
    
    // スタートボタンのイベント設定(pointerup イベントを使用)
    document.getElementById("start-button").addEventListener("pointerup", () => {
      initializeApp();
    });
  </script>
</body>
</html>


2025年2月20日木曜日

こっき(1)

まだ1歳10ヶ月の風葉ちゃんは国旗を覚えるのが得意だ。GGが知らない国の国旗を沢山知っている。ママからのリクエストで国旗アプリを考えることになった。市販のスマホアプリは1-2歳向けではないのだ。要求仕様は次のようなものになる。

(1) 世界の国旗が地域別(または全世界)に表示される。
(2) その下にはカタカナの国名が表示されている。ママだけが読める。 
(3) タップすると順に次の国旗が表示される。国名がわからなければママが解説する。
(4) 表示は,アルファベット順,アイウエオ順,ランダムとする。
(5) 地域は,東アジア・オセアニア,西・南アジア,ヨーロッパ,アフリカ大陸,アメリカ大陸とする。

本物のiPhoneアプリはハードルが高すぎるので,とりあえずWebアプリにしよう。もちろん,高齢者の脳力に頼っていては死ぬまでにできあがらないので,ChatGPT o3-mini-high にお願いするわけだ。自分が入れた一連のプロンプトは以下のとおりである。

Q(koshix):
幼児向けの国旗のウェブアプリを作ってください。
お母さんと子どもが一緒に遊べるものです。
・国旗の画面が大写しになります。
・その画面に国名が小さく表示されます。
・スライドするとつぎの国旗にうつります。
・表示順序をアルファベット順,五十音順,ランダムに設定変更できます。
国連に加盟しているすべての国や地域のフリーのイメージデータに
アクセスして表示できるようにします。

Q(koshix):
国名はカタカナにしてください。
クリックしたら次の国旗に進むようにしてください。それまでは静止です。

Q(koshix):
画面が真っ暗で表示されず,クリックしても進まないのですが。

Q(koshix):
(1) 国旗の表示が画面いっぱいになっているので,もう少し小さめにして余白領域を作ってください。
(2) 表示範囲を,東アジア〜オセアニア・南〜西アジア・ヨーロッパ・アフリカ大陸・アメリカ大陸の5領域および全世界の6つから選択できるようにしてください。
(3) iPhoneにこのhtmlファイルを転送して実行しようとすると,スタート時点でつまづいて進みません。iPhoneでも使えるように対処可能でしょうか。

Q(koshix):
ありがとうございます。機能はほぼ希望通りになりました。しかし,iPhoneでは画面が真っ暗のままで進まずに停まっています。どこかへのアクセスが拒否されているような感じです。どうすればよいでしょうか。

Q(koshix):
iPhoneだけでなんとかしたいので,外部にhttps対応サーバを準備することができないのですが。マウスクリック操作の機能部分ははタッチ操作に対応するようになっていますかね。

Q(koshix):
1.ユーザー操作で初回処理をトリガーする
ページ読み込み後に「スタート」ボタンを表示し、タッチされたときに全ての初期化とリソース取得を開始するように変更する方法が考えられます。これなら、iOS側での自動起動制限を回避できる場合があります。
2.ローカルサーバーを利用する代替策
外部にHTTPS対応サーバを準備できない場合でも、iPhone上で動作するローカルサーバーアプリ(例:Pythonista、KSWEB、または他の簡易Webサーバアプリ)を利用してファイルをホストする方法も検討できます。

これらの場合の具体的な手順を詳細に説明してください。

Q(koshix):
localでウェブサーバを立ち上げ,iphoneでアクセスすることに成功しました。

Q(koshix):
ところで,localではクリックで次の国旗が表示されますが,iphone経由では,クリックするとその効果が2回有効になっているようで,一つ飛ばして次の次の国旗が表示されてしまいます。どうすればいいでしょうか。

Q(koshix):
1の方法をとりたいのですが,元のコードで言うとどの部分の修正になりますか。修正後の全コードを教えてもらったほうが助かります。

Q(koshix):
最初のスタートで次に進むことができなくなりました。

Q(koshix):
ありがとうございます,うまくいきました。
トップ頁に「かざは の こっき」というタイトルをいれて,かざはの顔写真 kazaha.jpg  437x377 ピクセルを表示するように修正できますか。 kazaha.jpg はkokki.html と同じフォルダにあります。


図:世界の国旗(外務省から編集して引用)

pythonでローカルのウェブサーバを立ち上げ,ngrokでトンネルを設定すると,外部からローカルウェブサーバのコンテンツにアクセスすることができる。そこで,kokki.html(296行)とkazaha.jpgを置いたディレクトリでローカルウェブサーバを立ち上げておけば,ngrokが指定するURLでiPhoneからこの国旗Webアプリが使えるようになった。
python3 -m http.server 8000
ngrok http 8000
https://zzzzzzzzzz.ngrok.io/kokki.html 
問題は,ngrokを無料で使っている限りこのURLが永続的ではないことだ。sakuraインターネットに眠らせてあるWebサイトを起すべきだろうか。ChatGPTを使えば一日一ウェブアプリを公開することができる。

(付)http.server ファイルの中身
import http.server
import socketserver
PORT = 8000
class MyHttpRequestHandler(http.server.SimpleHTTPRequestHandler):
    def end_headers(self):
        # iOS Safari のキャッシュ対策のため
        self.send_header("Cache-Control", "no-store, no-cache, must-revalidate")        http.server.SimpleHTTPRequestHandler.end_headers(self)
Handler = MyHttpRequestHandler
with socketserver.TCPServer(("", PORT), Handler) as httpd:
    print("Serving at port", PORT)
    httpd.serve_forever()

2025年2月19日水曜日

Typst(2)

Typst(1)からの続き

自分のLaTeX利用ではTikZによる作図が大きな割合を占めている。TypstがLaTeXの代替の組版処理(文書整形)ツールとして使えるためには,TikZに相当する図形描画機能が必須だ。

調べてみると,CeTZというツールがある。CeTZ-plotもその仲間だ。関数やベジェ曲線にも対応しているので,TikZでこれまで作成してきたものは概ね再現できそうだ。具体例として,115 Scientific Diagrams というページに,物理や化学で用いられる図が,CeTZで74例,TikZで109例,示されている。

まだ慣れないからかもしれないが,TikZの方が使いやすいと思う。115 Scientific Diagramの同じ図で比較しても,CeTZの方が1TikZに比べて1.5倍程度の行数が必要だ。まあ,ないよりましなのだ。


図:CeTZによる凸関数の例(115 Scientific Diagrams から引用)


[3]115 Scienfitic Diagrams(Janosh Riebesell)

2025年2月18日火曜日

Typst(1)

奥村さんが Typst β版の新バージョンが出たことを話題にしていた。聞き覚えがあるような気もするが,早速インストールして試してみよう,というかこれは何をするものだ?

Typstは2023年に生まれた組版処理システム(PCで整形されたきれいな文書をつくるもの)だ。同種のものとして,ドナルド・クヌース(1938-)が1978年に開発したTeXや,レスリー・ランポート(1941-)がこれに続いて1984年に作ったLaTeXがある。まあ,Wordだってその仲間だ。咲子がLaTeXならば風葉がTypstだ。軽量マークアップ言語のMarkdown(2004)に数式表現が加わっている。同工のものとして日本発のSATySFy(2021)がある。

さて,ローカル版はhomebrewで簡単にインストールできる。sample.typ ファイルに対して, typst c sample.typ とすれば,sample.pdf が得られる。しかも,LaTeXよりずっと速い。typst w sample.typ とすれば,ソースコードを修正しながらこれが反映した結果のpdfファイルを確認できる。Typst.appにはWeb版もあって,登録すれば無料で利用できる。Sing In したところ,メールアドレスは登録済みだったので,昔いちど試してみたのかもしれない。もう忘れている。

LaTeXとTypstのコンバータがあれば便利だろうと,OpenAI o3-mini-high にやらせてみたところ,すぐにできたが,入力したtexファイルに問題があって,うまくいかなかった。そうこうしているうちに,ファイルコンバータのpandoc にはこの変換が組み込まれている(逆方向はダメ)ことがわかり,確かにうまくいった(\Big は\big に直す必要があった)。


図:Typst のアイコン(Typstのホームページから引用)

Q(koshix):
日本語と数式と図を含んだ組版システムとして,LaTeX(昔から)とTypst(最近)があります。この両者の特徴を比較して,どちらがお薦めかを教えてください。

A(Perplexity Pro):
LaTeXとTypstは、両者とも日本語、数式、図を含んだ文書の組版に適したシステムですが、それぞれに特徴があります。以下に両者を比較し、どちらがおすすめかを検討します。

LaTeXの特徴
長所:
・長年の実績があり、学術界で広く使用されている
・複雑な数式や特殊文字を正確に表現できる
・異なる要素のスタイルを厳密かつ一貫して制御できる
・すべてのOSと互換性がある
・数式や図表の自由な配置編集が可能
・安定性が高く、バグが少ない
短所:
・環境構築が複雑
・エラーメッセージが不親切で、デバッグが困難
・初心者には扱いづらい

Typstの特徴
長所:
・文法がわかりやすく、特に数式の記述が直感的
・エラーメッセージが親切で理解しやすい
・環境構築が簡単
・処理速度が非常に速い
・レイアウトの調整が容易
・LaTeXからの移行がしやすい
短所:
・比較的新しいシステムのため、LaTeXほどの実績がない
・英語のドキュメントしかない

おすすめ
どちらがおすすめかは、ユーザーの状況や目的によって異なります。
LaTeXをおすすめする場合:
・学術論文を執筆し、広く受け入れられているフォーマットが必要な場合
・複雑な数式や特殊な組版が必要な場合
・長期的なサポートや豊富なリソースが必要な場合
Typstをおすすめする場合:
・迅速な文書作成や編集が必要な場合
・環境構築の手間を省きたい場合
・より直感的な文法を好む場合
・処理速度を重視する場合

結論として、学術界での実績や豊富なリソースを重視するならLaTeXが、使いやすさや処理速度を重視するならTypstがおすすめです。ただし、Typstは比較的新しいシステムなので、今後の発展や学術界での受け入れ状況を注視する必要があります。
[1]Typst.app 公式ページ
[3]Typst入門(奥村晴彦)
[4]Typstの使い方(KumaROOT)
[5]Typstのはじめかた(monaqa)
[6]組版処理システムTypstの紹介(樫村博基)
[7]便利パッケージと使用例の紹介(Qiita,key_271)

2025年2月17日月曜日

失敗の本質

1月31日の日経朝刊,日経コメンテーターの中山淳史による「失敗の本質」野中郁次郎氏の遺産 野性こそ創造の源泉がおもしろかった。中山による生前の野中への取材をまとめたものだ。一橋大学名誉教授の野中郁次郎(1935-2025)は,カリフォルニア大学バークレー校でドクターを取得し,防衛大学校に所属しているときに「失敗の本質 日本軍の組織論的研究」を書いた。

脳トレのために,自力で要約してみよう。

第2次大戦における日本軍の様々な失敗の場面を分析したのが「失敗の本質」だ。その観点から日本の「失われた30年」を考える視点を尋ねたのが野中への取材の要目だった。日本の低迷の原因は普通「雇用,設備,債務の3つの過剰」だとされるが,野中は「プランニング(計画),アナリシス(分析),コンプライアンス(法令順守)の3つの過剰」だと強調した。

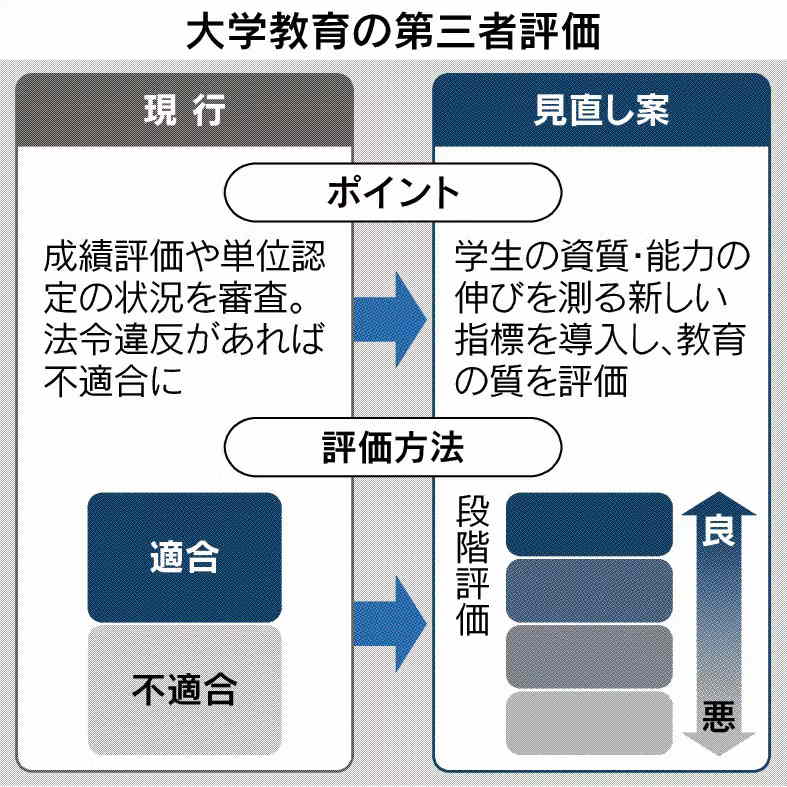
わかるわかる。PDCAだよ。国立大学法人化後の中期目標計画と認証評価制度のことだよ。そして今再び,中教審の大学分科会の中間報告からニュースのトップに取上げられたのがこれだ。あーぁ・・・。また屋上屋を重ねるのか。
文部科学省は大学の運営を第三者が審査する「認証評価制度」を見直す。在学中の学生の成長具合など、教育の質を測る指標をつくり、複数段階で評価する。受験生らが偏差値やイメージではなく、教育内容を比較して進学先を選べるようにする。大学間の切磋琢磨(せっさたくま)を促し、大学教育全体の質向上にもつなげる。

図1:大学教育の第三者評価(日経新聞2025.1.29より引用)


話を戻そう。野中は,日本のPDCA(計画・実行・評価・改善)が「PdCa」になってしまい肝心の行動と改善がおろそかになっていることを指摘する。計画や分析やルールづくりが行き過ぎ,自己目的化し,経営(研究教育)の活力を損なってしまうというわけだ。

これに替わるもの,提案したのがSECIモデルだ。それは組織における個人の暗黙値を集団で共有してイノベーションを推進するため,知識の生成と共有のプロセスをモデル化したものだ。徹底した対話で暗黙知を言葉や論理による形式知に変換し,最終的には集団で獲得した知の実践を通じて個人の暗黙知をもう一段高めていくものだ。

すなわち,SECI = 共同化(Socialization),表出化(Externalization),連結化(Combination),内面化(Internalization)というわけだ。


図2:野中郁次郎のSECIモデル(日経新聞2025.1.31から引用)

[1]大学の教育評価と成果の可視化(齊藤貴浩・林隆之)

2025年2月16日日曜日

ChatGPT o3-mini(3)

ChatGPT o3-mini(2)からの続き

東京理科大の数学の入試問題が話題になっていた。出題ミスだとかなんとか。その真偽はわからないのだけれど,この問題の最終段階で必要となる式を眺めると,ちょっと自分には解けなさそうだった。なさけない。以下の左辺から右辺を導くのだ。

$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{1}{2} + \dfrac{2\pi}{\sqrt{17}} \tan {\dfrac{\sqrt{17} \ \pi}{2}}$ 

Mathematicaでは,238μsで正解が得られる。ChatGPT o3-mini-highでは,やたら推論時間がかかってしまい途中では誤りもみられる。便利なようだけれど使い方は要注意。 
Q(koshix):
次の級数を求めてください。 Σ_{n=2}^∞ 2/(n^2+3n-2)

A(ChatGPT o3-mini-high):
(31秒かけて推論)
(導出過程省略)
【結論】
したがって,この級数の和は,
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{\sqrt{17}}{2}\Bigl[ \psi\Bigl(\dfrac{7+\sqrt{17}}{2}\Bigr) - \psi\Bigl( \dfrac{7-\sqrt{17}}{2}\Bigr) \Bigr] $ 
【補足】
・ここで用いたディガンマ関数$\psi(x)$は,$\psi(x) = \frac{d}{dx} \ln \Gamma(x)$と定義される特殊関数です。
・回答はこれ以上初等関数だけで簡単な形にまとめることは難しく,この形で示すのが一般的です。

このように、部分分数分解とディガンマ関数の性質を用いることで、与えられた級数を閉じた形で表すことができました。


Q(koshix):
ディガンマ関数を用いずに,高等学校数学の範囲に登場する関数で表現してください。

A(ChatGPT o3-mini-high):
(117秒かけて推論)
(導出過程省略)
【まとめ・最終回答】
部分分数分解と(望遠的な)和の評価により、特殊関数を使わず初等関数だけで表すと,
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{1}{\sqrt{17}} \ln {\dfrac{5+ \ \sqrt{17} }{5-\sqrt{17}}}  $ 

【補足】
・導出の途中で「拡張調和数」やディガンマ関数を用いる方法もありますが,最終結果は対数と平方根のみで表されています。
・(実際の解析では、各項の和を適切に並べ替え・打ち消すことでこの形が得られることが確認できます。)

以上が、特殊関数を用いず高等学校数学レベルの初等関数のみで表現した解答です。


Q(koshix):
その結果は間違ってますね。Tan が出てくるはずですが。

A(ChatGPT o3-mini-high):
(74秒かけて推論)
(導出過程省略)
【最終回答】
$\displaystyle \sum_{n=2}^{\infty} \dfrac{2}{n^2+3n-2} = \dfrac{2\pi}{\sqrt{17}} \tan {\dfrac{\pi \ \sqrt{17} }{2}} + \dfrac{1}{2} $ 
(解説省略)

2025年2月15日土曜日

ChatGPT o3-mini(2)

ChatGPT o3-mini(1)&「は、」からの続き

ChatGPT o3-mini の実力をなかなか試せていない。そこで,係助詞「は」直後の読点問題に挑戦させてみた。ChatGPT o3-mini-highで試したところ,正しいコードが一発で得られた。「、」に「,」を追加する修正も楽々。ただし,自分の環境設定に問題があった。o3-mini-highのアドバイスをもらいながら修正を試みる。

(1)  source ./myenv/bin/activate でvenv環境に移行する。
(2)  python3 -m pip install mecab-python3 でmecab-python3 をインストールする。
(3)  pip install --upgrade pip で pipのバージョンをあげた。(23.1.2 → 25.0)
(4)  python3 jta.py text.txt で /usr/local/etc/mecabrc が見つからないとのエラー。
(5)  sudo mkdir /usr/local/etc で etcディレクトリを作成。
(6)  sudo ln -s /opt/homebrew/etc/mecabrc  /usr/local/etc/mecabrc でシンボリックリンクを作成。
(7) (venv) python -m jta text.txt で実行できた(データはtext.txtに入っている)。
(8) 自分のブログ記事のいくつかを入れてコマンドラインで実行した結果の例:

=== 全体の統計 ===
句点「。」の数:  72
読点(「、」と「,」)の数:  66
一文あたりの平均読点数: 0.92

=== 係助詞「は」の統計 ===
係助詞「は」の出現数:  51
直後に読点がくる確率: 0.16

=== 係助詞「は」の直後に読点がある文の統計 ===
文数:  8
平均文字数: 137.62
平均読点数: 1.38

=== 係助詞「は」の直後に読点がない文の統計 ===
文数:  32
平均文字数: 38.19
平均読点数: 0.91

思ったより,自分は「は,」を多用していなかった。傾向も原論文と一致している。o3-miniに任せればコードはスイスイとできるとはいうものの,やはり一定のプログラム作成の知識は必要だ。その上,自分の知識は継ぎ接ぎ穴だらけであり,いきあたりばったりのアドホックな対応でごまかしているところに問題がある。

Q(koshix):
日本語のテキストの解析プログラムをつくりたいです。
テキストがファイルで与えられたとき,これを形態素解析して,
係助詞の「は」がわかるようにします。
(1) 句点と読点の数および,一文あたりの平均読点数を求める。
(2) 係助詞「は」の出現数とその直後に読点がくる確率を求める。
(3) 係助詞「は」の直後に読点がある場合とない場合について,
これを含む文の平均文字数と平均読点数を求める。
これらの機能を持つ日本語解析プログラムを作ってください。

A(ChatGPT o3-mini-high):
以下は、Python と形態素解析ライブラリ MeCab を用いて、指定された3つの解析機能を実現するサンプルプログラムの例です。

以下のコードでは、
・ファイルからテキストを読み込み、
・全体での句点(「。」)と読点(「、」)の出現数および一文あたりの読点数を求め、
・MeCab による形態素解析で「は」が係助詞(形態素情報で「助詞,係助詞」)として出現している場合をカウントし、その直後のトークンが読点(「、」)であるかどうかをチェックし、
・さらに「は」の直後に読点がある場合とない場合で、その文(=句点で区切った文)の文字数と読点数の平均を算出しています。

なお、このプログラムを実行するには、Python 用の MeCab ライブラリ(例:mecab-python3)がインストールされている必要があります。
以下、コードの全体像とともに、各ステップの処理内容についてコメントで説明しています。
(以下略)

Q(koshix):
以下のプログラムの読点を,「、」と「,」の両方に同時に対応できるように修正してください。(先ほどのコードを貼り付ける)

A(ChatGPT o3-mini-high):
(以下は出力されたコードのみで解説を省く,このコードを jta.py とする。)

#!/usr/bin/env python
# -*- coding: utf-8 -*-

"""
日本語テキスト解析プログラム

【機能】
(1) ファイル内のテキスト全体について,
    ・句点「。」と読点「、」および「,」の出現数
    ・一文あたりの平均読点数
    を求める。

(2) MeCab を用いて形態素解析を行い,
    ・係助詞「は」の出現数
    ・その直後に読点がくる確率
    を求める。

(3) 係助詞「は」の直後に読点がある場合とない場合で,
    ・その文の平均文字数
    ・その文の平均読点数
    を求める。
    
※実行例: python japanese_text_analyzer.py input.txt
"""

import MeCab
import argparse

def analyze_text(text):
    # (1) 句点と読点の総数、及び一文あたりの読点数
    total_period = text.count("。")
    # 読点は「、」と「,」の両方に対応
    total_comma = text.count("、") + text.count(",")
    
    # 文章を「。」で分割して文単位にする(文末の句点を補完)
    sentences = []
    for s in text.split("。"):
        s = s.strip()
        if s:
            sentences.append(s + "。")
    num_sentences = len(sentences)
    avg_comma_per_sentence = total_comma / num_sentences if num_sentences > 0 else 0

    # (2) および (3) の解析用に、形態素解析器を初期化
    tagger = MeCab.Tagger()
    
    # 係助詞「は」についての統計
    total_ha_occurrences = 0     # 「は」の出現回数(係助詞として)
    ha_followed_by_comma = 0       # 「は」の直後に読点がある回数
    
    # (3) 用の文ごとの集計
    groupA_sentences = []  # 「は」の直後に読点がある場合を含む文
    groupB_sentences = []  # 「は」の直後に読点がない場合を含む文

    # 各文ごとに形態素解析を実施して処理する
    for sentence in sentences:
        # MeCab で形態素解析(各文を対象)
        node = tagger.parseToNode(sentence)
        tokens = []
        while node:
            # BOS/EOS ノードは除外
            if node.stat in (MeCab.MECAB_BOS_NODE, MeCab.MECAB_EOS_NODE):
                node = node.next
                continue
            # node.feature は「品詞,品詞細分類1,品詞細分類2,品詞細分類3,活用形,活用型,原形,読み,発音」などの情報
            features = node.feature.split(",")
            pos = features[0]               # 例:"助詞"
            pos_detail1 = features[1]       # 例:"係助詞"(係助詞ならこの値)
            # 原形は features[6] だが、情報がない場合もあるので、surface を利用する
            base = features[6] if len(features) > 6 else node.surface
            tokens.append({
                'surface': node.surface,
                'pos': pos,
                'pos_detail1': pos_detail1,
                'base': base
            })
            node = node.next

        # 各文中の「は」に関して、直後のトークンが読点「、」または「,」かどうかをチェック
        sentence_has_ha_followed_comma = False
        sentence_has_ha_not_followed_comma = False
        
        for i, token in enumerate(tokens):
            # 係助詞としての「は」を対象にする
            if token['surface'] == "は" and token['pos'] == "助詞" and token['pos_detail1'] == "係助詞":
                total_ha_occurrences += 1
                # 直後のトークンが存在するかどうかをチェック
                if i + 1 < len(tokens):
                    next_token = tokens[i + 1]
                    if next_token['surface'] in ("、", ","):
                        ha_followed_by_comma += 1
                        sentence_has_ha_followed_comma = True
                    else:
                        sentence_has_ha_not_followed_comma = True
                else:
                    # 直後にトークンがなければ「読点なし」と判断
                    sentence_has_ha_not_followed_comma = True

        # (3) の集計対象として文をグループ分け(※文中に複数の「は」がある場合,
        #  直後に読点がある場合とない場合の両方に該当する可能性があります)
        if sentence_has_ha_followed_comma:
            groupA_sentences.append(sentence)
        if sentence_has_ha_not_followed_comma:
            groupB_sentences.append(sentence)

    # (2) 「は」の直後に読点が来る確率
    prob_ha_comma = ha_followed_by_comma / total_ha_occurrences if total_ha_occurrences > 0 else 0

    # (3) グループごとの文の平均文字数と平均読点数を計算する関数
    def average_metrics(sent_list):
        total_chars = 0
        total_commas_in_sent = 0
        for s in sent_list:
            total_chars += len(s)
            total_commas_in_sent += s.count("、") + s.count(",")
        count = len(sent_list)
        if count == 0:
            return (0, 0)
        return (total_chars / count, total_commas_in_sent / count)
    
    avg_len_groupA, avg_comma_groupA = average_metrics(groupA_sentences)
    avg_len_groupB, avg_comma_groupB = average_metrics(groupB_sentences)
    
    # 結果の出力
    print("=== 全体の統計 ===")
    print("句点「。」の数: ", total_period)
    print("読点(「、」と「,」)の数: ", total_comma)
    print("一文あたりの平均読点数: {:.2f}".format(avg_comma_per_sentence))
    print("")
    
    print("=== 係助詞「は」の統計 ===")
    print("係助詞「は」の出現数: ", total_ha_occurrences)
    print("直後に読点がくる確率: {:.2f}".format(prob_ha_comma))
    print("")
    
    print("=== 係助詞「は」の直後に読点がある文の統計 ===")
    print("文数: ", len(groupA_sentences))
    print("平均文字数: {:.2f}".format(avg_len_groupA))
    print("平均読点数: {:.2f}".format(avg_comma_groupA))
    print("")
    
    print("=== 係助詞「は」の直後に読点がない文の統計 ===")
    print("文数: ", len(groupB_sentences))
    print("平均文字数: {:.2f}".format(avg_len_groupB))
    print("平均読点数: {:.2f}".format(avg_comma_groupB))

def main():
    # コマンドライン引数で対象のファイルを指定
    parser = argparse.ArgumentParser(description="日本語テキスト解析プログラム")
    parser.add_argument("file", help="解析対象のテキストファイルパス")
    args = parser.parse_args()
    
    # ファイルの読み込み(UTF-8 エンコード前提)
    try:
        with open(args.file, "r", encoding="utf-8") as f:
            text = f.read()
    except Exception as e:
        print("ファイルの読み込みに失敗しました:", e)
        return
    
    analyze_text(text)

if __name__ == "__main__":
    main()

[1]OpenAI o3-mini (OpenAI)

2025年2月14日金曜日

「は、」

歳をとっても衰えない脳機能として言語能力があると聞いたことがある。ところが昔から国語や作文は苦手で,今でも文章を綴るのが億劫だ。Blogを書いていても,どこで句読点を入れるかは悩みの種だ。ちょっと気をゆるすと,同じいいまわしや表現が共鳴して繰り返されてしまう。だらだらとつながった長文を書いてしまう。

たぶん,自分にはちょっと「読点」を入れ過ぎる傾向があると思う。そんなおりに「は」の直後に「、」は必要か?というニュースが目についた。日本語教育学の岩崎拓也,井伊菜穂子さんの「人文系論文における係助詞「は」直後の読点使用の傾向と指導指針」という論文の話題だ。

人力でまとめてみよう。この論文は,

日本語教育,特にアカデミックライティングにおいて,係助詞の「は」直後の読点の打ち方をどのように指導すればいいかを考察することが目的だ。そのために,人文系の学会誌(日本語教育学,日本語学,日本文学)の60本の論文を対象として,「は」の直後に読点を打つ要因を分析したものである。

任意抽出された論文から,mecabで形態素解析したものをRで処理して3-gramをつくった。用例文の総数は9501である。「は」の次に読点がくる要因として,(1) 一文中の読点の数,(2) 一文の長さ(文字数),(3)  「は」直後の文字種,(4)  「は」の段落内の位置,(5) 論文の書き手, を考えて,一般化線形モデルで分析する(ここは何をしているのかよく理解できていない)。

結論に行こう。この分析の結果の多数派=結論が日本語指導指針としてまとめられた。
・ 「は」直後に読点を打つ確率は30%程度であり、基本的には「は」直後の読点は打たなくてもいいこと。
・ ただし、下記の条件の場合は「は」直後に読点を打つ場合が多いこと。
①一文中の読点数が少ない場合。
 ※目安として、一文中の読点数が2 個程度の場合(「は」直後の読点を含まない)に「は」直後の読点を打つ。
②一文が70 字程度の長さがある場合。
 ※目安として、一文が一行半から二行程度の場合に「は」直後の読点を打つ。
 (MS Word のデフォルトの設定が一行40 字であるため。)
③形式段落の冒頭(一文目)で「は」が使用されている場合。
 ※とくに形式段落の冒頭の文がトピックセンテンスである場合は、「は」直後の読点を打つ。
なるほど,そうなのか。多数派が正しいものとして良いのかが,ちょっとだけ引っかかる。


図:「は、」(ITmedia NEWSから引用)

2025年2月13日木曜日

索引たんご(2)


前回,5.pyというローカルの単語パズルプログラムを OpenAI o3-mini-high に作成させた。これだと,本家のパズルゲームを解くことにはならない。そこで,一日一度だけトライできる「索引たんご」の解法支援プログラムも考えることにした。

Q(koshix):
カタカナ5文字の単語当てゲームが外部サイトにあります。
そのロジックは別添のプログラムのようになっています。

単語当ての推定解をユーザが外部サイトに入れると,現時点の最小値と
最大値のいずれかが推定解に置き換わって,正解から最小値や最大値までの
距離がパーセンテージ比率で与えられます。
それをみながらユーザは次の新たな推定解を外部サイトに入力するのです。

外部サイトのゲームが持っている辞書や正解は秘匿されていますが,
自分の手元にある同様の辞書(別添ブログラム参照)と
外部サイトのゲームが返答するパーセンテージを使って
正解を推定する支援プログラムを新たに自分の手元に作りたいと思います。
この支援プログラムには,推定解の5文字単語とパーセンテージを入力します。
それを受けて新たな正解の候補を返してくれるわけです。

ここまでで,何か質問はありますか。
(別添のプログラムとして前回の5.py 105行をここにおいた)

A(OpenAI o3-staff-high):
(24秒の推論の後)
以下、現状の理解と実装にあたって確認したい点をいくつか挙げさせていただきます。
【現状の理解】
(9行 省略)
【確認・質問事項】
(26行 省略)
以上の点についてご確認いただけますでしょうか?
これらの点を明確にさせていただくことで、より正確でご希望に沿った支援プログラムの設計案をご提案できると考えております。 
 
Q(koshix):
(1) 外部サイトの辞書は約12000語を持っていますが(29795語ではありません),その詳細はこちらには不明です。
最小値「アアアアア」,最大値「ンンンンン」が初期値として設定されおり,
正解との関係を判断してこれらの境界が更新されます。

(2) 外部サイトの下限から正解までの割合p1と上限から正解までの割合p2は
p1+p2=100%になるように設定されています。

(3) 外部サイトから得られる情報は,更新された「最小値」と更新された「最大値」と
これらから正解までの距離を表すパーセンテージになります。

(4) 支援プログラム(こちらの辞書は29795語)の初期値も,最小値「アアアアア」,最大値「ンンンンン」であり,内部情報としてこれらが更新され,対話的に使用します。
つまり支援プログラムの最小値や最大値は外部サイトのそれと常に一致しています。

(5) 正解は必ず最小値と最大値の範囲に入るように,推定値を入れていきます。
条件に当てはまらない場合は推定値の再入力が促されます(外部でも支援でも)。
したがって,最小値<正解<最大値を満たすので,パーセンテージは必ず計算できます。

(6) 候補はひとつだけ返してください。

(7) 支援プログラムが使うローカル辞書と外部サイトが使う外部辞書は異なっています。
それでも両者が相似関係にあるとして推定をすることになります。

さらに,質問はありませんか。

A(OpenAI o3-staff-high):
(21秒推論の後)
以下、現状の理解と、実装に向けた最終確認として追加の質問事項をまとめさせていただきます。
【現状の理解】
(20行 省略)
【追加で確認させていただきたい点】
(28行 省略)
以上、上記の点についてご確認いただければ、より正確な支援プログラムの設計・実装の提案が可能です。
何かご不明点や追加で伝えていただくべき事項があればお知らせください。


Q(koshix):
(1) 境界はローカル辞書の中に必ず存在します。
(2) p1の式はOK。内部プログラムでは小数点以下1桁までで十分,外部プログラムは小数点以下四捨五入した1-2桁の整数で%を返してきます。

A(OpenAI o3-staff-high):
(12秒推論の後)
以下、現時点での理解内容を整理するとともに、今後の実装方針について確認させていただきます。
【整理した前提・仕様】
(26行 省略)
【今後の実装方針について】
(16行 省略)
【確認事項】
(9行 省略)
上記内容で問題なければ、この前提に沿って支援プログラムの実装案をご提案させていただきます。
また、上記以外にご不明点や追加でご要望などございましたら、お知らせください。

Q(koshix):
入力インターフェイスはそれで結構です。コマンドラインでの応答。
その他の補正は不要です。それではプログラムをつくってください。

A(OpenAI o3-staff-high):
(46秒推論の後)
以下は、上記の前提条件と仕様に沿って作成した Python プログラムの例です。
(説明10行 省略)
(プログラム120行 省略)
プログラムの使い方
(15行 省略)
このプログラムは、コマンドラインで対話的に実行可能です。
ご不明点や追加のご要望があればお知らせください。

この支援プログラムを使って「索引たんご」を解いてみたところおおむねOKだったけれど,問題点が1つ発覚した。元の「索引たんご」の辞書は,ソートの段階では濁点や半濁点を除いたものとして扱っていた。これに対して前回説明したローカルの支援プログラムの辞書は,通常のソートルールに則っている。そこで,ローカルの辞書から「索引たんご」形式の辞書に変換するプログラムもOpenAI o3-mini-highに作らせた。プログラミングがはかどるわ。

Q(koshix):
次の形式のCSVファイル5.csvがある。
1,アアアアア,
2,アイアンズ,
3,アイアース,
・・・
29793,ンドンバシ,
29794,ンバラカダ,
29795,ンンンンン,

5文字のカタカナが五十音順にソートされて番号が付けられている。

ここで,濁点や半濁点の文字をそれを取り去った文字として扱って
ソートし直して付番した新しいCSVファイル55.csvを出力する
プログラムを作ってください。

例えば,「ガンシップ」は比較の際に「カンシッフ」としてソートして
付番するが,出力CSVファイル上は,「ガンシップ」のままである。

A(OpenAI o3-mini-high):
(8秒推論の後)
【解説・手順】
(14行 省略)
【コード例】

import csv
import unicodedata

def remove_diacritics(text):
    """
    文字列 text を Unicode 正規化 (NFD) し、
    濁点・半濁点(結合文字)を取り除いた文字列を返す。
    """
    # NFD正規化により合成文字を分解する
    normalized = unicodedata.normalize('NFD', text)
    # 結合文字(濁点や半濁点など)を除去して再結合する
    return ''.join(ch for ch in normalized if not unicodedata.combining(ch))

def main():
    input_filename = "5.csv"
    output_filename = "55.csv"

    # CSVの各行は [番号, カタカナ文字列, (その他)] と仮定
    rows = []
    with open(input_filename, newline="", encoding="utf-8") as csvfile:
        reader = csv.reader(csvfile)
        for row in reader:
            if len(row) < 2:
                continue  # 少なくとも番号と文字列がある行のみ対象
            # row[1] がカタカナの5文字であると仮定
            # ソートキーは、row[1] に対して濁点・半濁点を除去したもの
            key = remove_diacritics(row[1])
            rows.append((row, key))

    # ソート実行:変換後の文字列で五十音順に並べ替える
    # 注意:日本語の五十音順に近いソートとなるが、完全な辞書順ではない場合もあるので
    # 必要に応じて locale.strxfrm() などの利用も検討してください。
    sorted_rows = sorted(rows, key=lambda x: x[1])

    # 出力時に新しい番号を付ける
    with open(output_filename, mode="w", newline="", encoding="utf-8") as csvfile:
        writer = csv.writer(csvfile)
        for new_index, (orig_row, _) in enumerate(sorted_rows, start=1):
            # もとの行の1列目(番号)を新しい番号に置き換える
            # もとの行の他のフィールドはそのまま残す
            new_row = [str(new_index)] + orig_row[1:]
            writer.writerow(new_row)

if __name__ == "__main__":
    main()

【ポイント解説】
(14行 省略)

2025年2月12日水曜日

索引たんご(1)

単語あてと推論AIからの続き

一日に一回トライできるパズルゲームの索引たんご。12回のトライで正解を挟み込む必要があるのだけれど,これが中々に難しい。単語辞書中の正解の位置が左にパーセンテージで表示されているので,辞書があればより確実に推定できるはずだけれど,それは公開されていない。

しかたがないので,代替の辞書がないものかと探してみたところ,言語資源開発センターの『現代日本語書き言葉均衡コーパス』短単位語彙表(Version 1.0)にたどり着いた。なんとなくそれらしい雰囲気が漂っている。Creative Commonsライセンス(CC BY-NC-ND)なので私達には使いやすい。

8MBのgzipファイルを解凍してできたTSVファイルをmacOSのNumbersに読み込ませて,品詞属性や統計データを取り除いて,正規表現で5文字だけのデータを選び出すと36785語が得られた。さらに,sortしてuniqをかけて同音異義語を排除すると29795語になる。ただし両端に「アアアアア」と「ンンンンン」を加えている(実際は,Excelがユニコードに弱いので慣れないNumbersでの作業を強いられたりして,結構面倒なクレンジングになった)。

これをOpenAI o3-mini-highにプログラムに依頼するのだけれど,そのロジックを考えるのに難儀する。こういうことは丁寧な段取りが重要なのである。一発で動くコードができたので,あとは2-3回微修正を入れるとスイスイとできあがった。ロジックの中身はブラックボックスでも構わないが,各動作の機能仕様やデータ構造は押さえる必要があって,今後のプログラミング教育の方向性は若干かなり変わってくるかもしれない。

Q(koshix):
1から29795まで五十音順に番号のついた5文字のカタカナを格納したファイル5.csvがあります。このプログラムがランダムに発生する1-29795の整数m0に対応するファイル内の 5文字のカタカナc0を当てるゲームです。正解のans=(m0,c0)とします。 最小の推定値min=(m1,c1)の初期値は(1,アアアアア)です。 最大の推定値max=(m2,c2)の初期値は(29795,ンンンンン)です。 ユーザはコマンドラインから5文字のカタカナ5文字cを入力します。 このようなコマンドラインで動作するプログラムを作ってください。

A(OpenAI o3-mini-high):
(28秒の推論の後)

以下は、Python を用いてコマンドライン上で動作するプログラムの例です。

このプログラムでは、まず CSV ファイル("5.csv")から 1~36787 番目の「5文字のカタカナ」を読み込み、

・辞書(word → 番号)およびリスト(番号 → word)の両方で管理します。
・ゲーム開始時に、ランダムに 1~29795 の整数 m₀ を選び、その番号に対応するカタカナ c₀ を正解とします。
・ゲームでは、初期の推定範囲を下限 (1, "アアアアア")、上限 (29795, "ンンンンン") とし、
ユーザが入力する 5文字のカタカナ(必ず CSV 内に存在するものとする)をもとに、
入力された単語の CSV 上の番号と正解の m₀ を比較します。
・もし入力の番号が m₀ より小さい場合は下限を更新し、
大きい場合は上限を更新します。
・ユーザの入力が正解に一致するまで繰り返します。

以下、コード例です。

import csv
import random

def load_katakana(file_path):
    """
    CSVファイル(例: "5.csv")から、番号と5文字カタカナの組を読み込み、
    番号→カタカナのリスト(インデックス番号は番号-1)と、
    カタカナ→番号の辞書を返す。
    CSVは各行が「番号,カタカナ」という形式である前提です。
    """
    total = 29795  # ファイルの行数
    words = [None] * total      # 番号 1~29795 に対応(リストのインデックスは 0~29794)
    katakana_to_index = {}
    
    with open(file_path, 'r', encoding='utf-8') as csvfile:
        reader = csv.reader(csvfile)
        for row in reader:
            if not row or len(row) < 2:
                continue
            try:
                idx = int(row[0])
            except ValueError:
                continue  # 番号が数値でない行はスキップ
            word = row[1].strip()
            if 1 <= idx <= total:
                words[idx - 1] = word
                katakana_to_index[word] = idx

    if any(w is None for w in words):
        raise ValueError("CSVファイルの読み込みに失敗しました。行数やデータ形式を確認してください。")
    
    return words, katakana_to_index

def print_range(lower_index, lower_word, upper_index, upper_word, target_index):
    """
    現在の推定範囲と、正解の位置を表すパーセンテージ (p1, p2) を表示する。
    p1: 下限から正解までの割合, p2: 正解から上限までの割合 (p1+p2=100)
    """
    range_span = upper_index - lower_index
    if range_span > 0:
        p1 = (target_index - lower_index) / range_span * 100
        p2 = 100 - p1
    else:
        p1, p2 = 0, 0
    print(f"現在の推定範囲: {lower_index}:{lower_word}  ~  {upper_index}:{upper_word}  (p1:{p1:.1f}%, p2:{p2:.1f}%)\n")

def main():
    file_path = "5.csv"
    
    try:
        words, katakana_to_index = load_katakana(file_path)
    except Exception as e:
        print(f"エラー: {e}")
        return

    # 初期の推定範囲の設定
    lower_index, lower_word = 1, "アアアアア"    # 最小の推定値
    upper_index, upper_word = 29795, "ンンンンン"  # 最大の推定値

    # 正解は、1~29795 の中からランダムに選ぶ(番号 m0 に対応する c0)
    target_index = random.randint(1, 29795)
    target_word = words[target_index - 1]
    
    attempts = 0
    print("=== カタカナ当てゲーム ===")
    print("CSVファイル内の5文字カタカナのうち、\n  番号 1~29795 に対応する単語を当ててください。")
    print_range(lower_index, lower_word, upper_index, upper_word, target_index)

    while True:
        # 試行回数を表示(例:1回目、2回目…)
        print(f"{attempts + 1}回目")
        guess = input("5文字のカタカナを入力してください: ").strip()
        attempts += 1
        
        if len(guess) != 5:
            print("入力エラー:5文字のカタカナを入力してください。\n")
            continue
        
        if guess not in katakana_to_index:
            print("入力されたカタカナはリストに存在しません。\n")
            continue
        
        guess_index = katakana_to_index[guess]
        
        if not (lower_index < guess_index < upper_index):
            print(f"入力された単語は現在の範囲外です。(現在の範囲:{lower_index}~{upper_index})\n")
            continue
        
        if guess_index == target_index:
            print(f"\n正解です!")
            print(f"{attempts}回目の試行で正解 (番号: {target_index}, カタカナ: {target_word}) に辿り着きました。")
            break
        elif guess_index < target_index:
            if guess_index > lower_index:
                lower_index, lower_word = guess_index, guess
            print("ヒント: 入力は小さすぎます。")
        else:  # guess_index > target_index
            if guess_index < upper_index:
                upper_index, upper_word = guess_index, guess
            print("ヒント: 入力は大きすぎます。")
        
        print_range(lower_index, lower_word, upper_index, upper_word, target_index)

if __name__ == "__main__":
    main()

プログラムのポイントと流れ

1.CSV 読み込み
・load_katakana 関数で CSV ファイルから全 29795 行を読み込み、
番号順にリスト words と、単語から番号を引く辞書 katakana_to_index を作成します。
2.正解の設定
・ランダムに 1~29795 の整数 target_index を選び、対応する単語 target_word を正解とします。
3.推定範囲の初期値
・下限は (1, "アアアアア")、上限は (29795, "ンンンンン") としておき、
ユーザの入力によって更新していきます。
4.ユーザ入力と比較
・ユーザはコマンドラインから 5文字のカタカナを入力します。
・入力された単語が CSV 内に存在し、かつ現在の推定範囲内であるかチェックします。
・単語に対応する番号を取り出し、正解の番号と比較します。
  *一致すればゲーム終了。
  *小さい場合は「ヒント:小さすぎる」と表示し、下限を更新。
  *大きい場合は「ヒント:大きすぎる」と表示し、上限を更新。
・現在の推定範囲を画面に表示し、正解するまで繰り返します。

この例は、インタラクティブな当てゲームとして動作します。実際にご利用になる際は、CSV ファイルの配置場所や文字コード(ここでは UTF-8 を想定)などをご確認ください。


図:本家の索引たんごの成功例(チートを利用した場合)
上記の辞書だけを用い,自力で位置を計算してやるとようやく正解にたどり着けた。

P. S.  上述の「『現代日本語書き言葉均衡コーパス』短単位語彙表」だけど,NumbersからExcelにファイル変換すればよかった。5文字以外も含めてすべてで18万5千語ある。このうち,36%が固有名詞,27%が漢語由来,21%が和語,12%が外来語だ。固有名詞の多くが外来語的なものになる。

2025年2月11日火曜日

点変換

量子ホール効果のあらましを少しだけ勉強する必要があった。自宅にある本は岩波書店の新物理学選書「量子ホール効果」吉岡大二郎と岩波講座現代の物理学18「局在・量子ホール効果・密度波」だ。

さっそく,前者をひもとくと電磁場中の荷電粒子における並進演算子の生成演算子がでてきて,K=p-eA+eB×r とあった。わからない。どこからでてきた。普通は,解析力学のラグランジアンを書いてネーターの定理を当てはめるのだけれど,具体的にどうすればいいかわからない。

しかたがないので,岩波講座 現代の物理学1「力学」の第1章Lagrange形式から読み直す。ふむふむ。そして点変換のところでつまづいた。一般座標(q_1,...,q_n)から(q'_1,...,q'_n)の変換が,各点同士に一対一対応がある場合,つまり,q'_i(t)=q'_i(q_1(t),...,q_n(t)) (i=1,...,n) と書けて,A_ij = ∂q'_i(t)/∂q_j(t) という変換行列の行列式がゼロでなく有限になるという条件のあるときだ。

この点変換に対して,ラグランジアンが不変になるという話が必要であった。その導出過程に,∂p_j(t)/∂p'_i(t) = ∂q_j(t)/∂q'_i(t) という式が現われる(ただし,p(t) ≡ d/dt q(t) )。老人の頭はかたく,いろいろ調べても考えてもこれがわからない。四苦八苦したあげくAIにきいてみた。

あららなんと,正しい導出過程を教えてくれるではないか。推論できるChatGPT o1 だけでなく,GeminiやDeepSeek でもそれなりの答えが得られた。うーん,ついにAIは普通の人間の理解力を越えてきたかと感慨深いものがある。いやたんに自分が惚けてきただけか。

Q(koshix):
解析力学の一般論です。
q(t) = (q_1(t), … ,q_n(t)) であり,自由度nの系を扱っている。
以下,\dot{q}(t) = p(t) と表記し,q(t) p(t)などの(t)は省略する。
ラグランジアンLが点変換に対して不変であるとは,変換後のL'が次式を
L'(q',p',t) ≡L(q,p,t) で与えられることを意味する。
点変換であるため,δq'_i=Σ_j ∂q'_i/∂q_j δq_j などが成り立つ。

このとき,以下の関係式が成立することを導いてください。
∂L'(q',p',t)/∂p'_i = Σ_j ∂L(q,p,t)/∂p_j・∂p_j/∂p'_i = Σ_j ∂L(q,p,t)/∂p_j・∂q_j/∂q'_i

A(DeepSeek V3):
解析力学における点変換に対するラグランジアンの不変性から、以下の関係式を導出します。

前提条件
・ラグランジアンL(q,p,t) が点変換に対して不変である。
・点変換後のラグランジアンをL'(q',p',t)とし,L'(q',p',t)≡L(q,p,t)が成り立つ。
・点変換により,q'i=q'i(q,t)およびp'i=p'i(p,t)が定義される。
・点変換の性質から。δq'i=Σj∂q'i/∂q'jδqjが成り立つ。
​
目標
以下の関係式を導出する:
∂L'(q',p',t)/∂p'i = Σj ∂L(q,p,t)/∂pj・∂pj/∂p'i = Σj ∂L(q,p,t)/∂pj・∂qj/∂q'i
​
導出過程
1.ラグランジアンの不変性:
点変換に対してラグランジアンが不変であるため,次式が成り立つ:
L'(q',p',t) = L(q,p,t)
ここで,q'とp'はqとpの関数である。

2.偏微分の連鎖律:
L'をp'iで偏微分するために,連鎖律を適用する:
∂L'(q',p',t)/∂p'i = Σj(∂L(q,p,t)/∂qj・∂qj/∂p'i + ∂L(q,p,t)/∂pj・∂pj/∂p'i)
ここで,qjはp'iに依存しないため,∂qj/∂p'i=0となる。したがって,次式が得られる。
∂L'(q',p',t)/∂p'i = Σj ∂L(q,p,t)/∂pj・∂pj/∂p'i

3.点変換の性質を利用:
点変換の性質から,pjとp'iの関係は,qjとq'iの関係と対応する。具体的には,運動量pjは
一般加速度\dot{q}jに関連しており,点変換により\dot{q}'i=Σj∂q'i/∂qj \dot{q}j が成り立つ。
したがって,運動量の変換も同様の関係を持つ:
pj = Σi p'i ∂q'i/∂qj
これを逆に解くと、次式が得られる:
∂pj/∂p'i = ∂qj/∂q'i

4.最終的な関係式
上記の結果を代入すると,次式が得られる:
∂L'(q',p',t)/∂p'i = Σj ∂L(q,p,t)/∂pj・∂qj/∂q'i
​
5.結論
以上から、以下の関係式が成立する:
∂L'(q',p',t)/∂p'i = Σj∂L(q,p,t)/∂pj・∂pj/∂p'i = Σj ∂L(q,p,t)/∂pj・∂qj/∂q'i
P. S. これはR1ではなく,V3の結果である。問題自身がそんなにややこしいものではなく,常識的な論理の範囲ででてきたものだ。それが思いつかなかった自分がアホだったということ。一方,DeepSeek R1も別の問題で試してみたが,こちらはより時間をかけて推論が行われ,その過程の説明文が明示されている。

2025年2月10日月曜日

電磁場中の荷電粒子

 物理系の運動=状態変化が,時間を変数とする力学変数に対する微分方程式系で表される。適当な初期条件の下で,この微分方程式系を時間で順次積分することにより物理系の運動状態変化が求まる。これとは異なって,初期条件と終期条件が固定されたすべての仮想的に可能な(状態変化)経路の中から変分原理によって物理的に実現される経路が定まると考えることもできる。

この系の力学変数のある関数を,経路にわたって時間で積分した量を構成する。これを作用とよぶ。あらゆる仮想的な経路についての作用の集合の中から,実際に実現される物理系の(状態変化)経路を選び出す条件は,作用が停留値を取ることであると考える。

これが停留作用の原理(最小作用の原理)とよばれるものであり,力学変数の関数をラグランジアンとよんでいる。

力学変数を$\bm{q}(t) \equiv \{ q_i(t)\ (i=1,\ \dots n) \}$とし,経路は$\bm{q}(t) \ (t_0 \le t\le t_1) $である。また,始点と終点は,$\bm{q} (t_0) , \bm{q}(t_1) $で表される。

ラグランジアンを$L=L(\bm{q}(t), \dot{\bm{q}}(t), t)$とすると,作用$S$は,$\displaystyle  S[\bm{q}]= \int_{t_0}^{t_1}  L(\bm{q}(t), \dot{\bm{q}}(t), t) dt$ となる。これが停留値となって物理的に実現される経路を$\bm{q}(t)$として,停留作用の原理が成り立つ条件を表すと,

$\bm{q'}(t)=\bm{q}(t) + \delta\bm{q}(t), \ \dot{\bm{q'}}(t)=\dot{\bm{q}}(t) + \dfrac{d}{dt}\delta\bm{q}(t) \equiv \dot{\bm{q}}(t) + \delta\dot{\bm{q}}(t) $として,$\delta \bm{q}(t_0) = \delta \bm{q}(t_1)=0$ および,\\

$\displaystyle \delta S = S[\bm{q'}]-S[\bm{q}]= \int_{t_0}^{t_1} \Bigl\{ L(\bm{q'}(t), \dot{\bm{q'}}(t), t) - L(\bm{q}(t), \dot{\bm{q}}(t), t) \Bigr\} dt = 0$

これから,$ L(\bm{q}(t), \dot{\bm{q}}(t), t) \rightarrow L(\bm{u},\bm{v},t) = L$として,

$\displaystyle  \int_{t_0}^{t_1} \Bigl\{ \dfrac{\partial L}{\partial \bm{u} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \delta \bm{q}(t) \ + \dfrac{\partial L}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \delta\dot{\bm{q}}(t)  \Bigr\} dt $

$\displaystyle = \int_{t_0}^{t_1} \Bigl\{ \dfrac{\partial L}{\partial \bm{u} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \delta \bm{q}(t) \ + \dfrac{d}{dt}\Bigl( \dfrac{\partial L}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \delta{\bm{q}}(t) \Bigr)  - \dfrac{d}{dt}\Bigl( \dfrac{\partial L}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \Bigr)\delta \bm{q}(t) \Bigr\} dt $

$\displaystyle = \int_{t_0}^{t_1} \Bigl\{ \dfrac{\partial L}{\partial \bm{u} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} - \dfrac{d}{dt}\Bigl( \dfrac{\partial L}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \Bigr) \Bigl\} \delta \bm{q}(t) dt + \Bigl[ \dfrac{\partial L}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \delta \bm{q}(t) \Bigr]_{t=t_0}^{t=t_1} = 0$

第3項は0であり,任意の$\delta \bm{q}(t)$ についてこの式が成り立つためには

$\dfrac{\partial L(\bm{u}, \bm{v}, t)}{\partial \bm{u} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} - \dfrac{d}{dt}\Bigl( \dfrac{\partial L(\bm{u}, \bm{v}, t)}{\partial \bm{v} } \Bigr|_{\bm{u}=\bm{q}, \bm{v}=\dot{\bm{q}}} \Bigr) = 0$ あるいは,$\displaystyle \dfrac{\partial L}{\partial q_i} - \dfrac{d}{dt} \dfrac{\partial L}{\partial \dot{q}_i} = 0 \ (i=1,\dots n)$

このn本の連立微分方程式を オイラー・ラグランジュの方程式という。

ある物理系に対して同じラグランジアンや作用は一意的に定まらない。例えば,

$ L(\bm{q}, \dot{\bm{q}}),t )  \rightarrow L' (\bm{q}, \dot{\bm{q}}),t )= L (\bm{q}, \dot{\bm{q}}),t ) + \dfrac{d}{dt} W(\bm{q},t)$ とすれば,作用には $\displaystyle \int_{t_0}^{t_1} \dfrac{d}{dt} W(\bm{q},t) dt = W(\bm{q}(t_1), t_1) - W(\bm{q}(t_0),t_0)$の項が付け加わるが,停留値の計算には影響しないので,同じ,オイラー・ラグランジュの方程式を与える。

電磁場中の荷電粒子,$\bm{r}=\{q_i i=1,2,3 \} $,電荷 $q$)が,スカラーポテンシャル$\phi(\bm{r}),t$,ベクトルポテンシャル$\bm{A}(\bm{r},t)$中を運動する場合,ラグランジアンは$L(\bm{r},\dot{\bm{r}},t) = \dfrac{m}{2} \dot{\bm{r}}^2 - q \phi(\bm{r},t) +q \dot{\bm{r}} \cdot  \bm{A}(\bm{r},t)$となる。

オイラー・ラグランジュの方程式は,

$\displaystyle 0 = \dfrac{\partial L}{\partial \bm{r}} -\dfrac{d}{dt} \dfrac{\partial L}{\partial \dot{\bm{r}}} = -q \dfrac{\partial \phi(\bm{r},t)}{\partial \bm{r}} +q \dot{\bm{r}}\cdot \dfrac{\partial \bm{A}(\bm{r},t)}{\partial \bm{r}} -\dfrac{d}{dt}\Bigl( m \dot{\bm{r}} + q \bm{A}(\bm{r},t) \Bigr)$

$\displaystyle 0=-m \ddot{\bm{r}} -q \Bigl( \dfrac{\partial \phi(\bm{r},t)}{\partial \bm{r}} +\dfrac{\partial \bm{A}(\bm{r},t)}{\partial t}  \Bigr) + q \Bigl( \dot{\bm{r}}\cdot \dfrac{\partial \bm{A}(\bm{r},t)}{\partial \bm{r}} - \dfrac{\partial \bm{A}(\bm{r},t)}{\partial \bm{r}} \cdot \dot{\bm{r}} \Bigr)$

つまり,$m \ddot{\bm{r}} = q \bm{E}(\bm{r},t) + q \dot{\bm{r}} \times \bm{B}(\bm{r},t)$

ここで,$\bm{E} (\bm{r},t) =  -\nabla \phi(\bm{r},t) -\dfrac{\partial \bm{A}(\bm{r},t)}{\partial t} $

 および,$\bm{B} (\bm{r},t) = \sum_{ij} \varepsilon_{ijk} \bigl( \nabla_i A_j - \nabla_j A_i \bigr) = \nabla \times \bm{A}(\bm{r},t)$

2025年2月9日日曜日

立ちタイム

家人から「高齢者が1日20分程度立つ時間や機会を作ることは,立つ能力を維持し寝たきりになることを防ぐのに役立つ」と聞いた。調べてみるとGoogleもそう言っている。

老人が立っている時間を計測するアプリを作ると儲かるのではないかと考えた。考えるだけはタダなので。こんな場合,推論モデルの生成AI(DeepSeek R1とChatGPT o1)に聞いてみるといいかもしれない。なお「立ちタイム」というアプリ名はDeepSeekの提案だ。

Q(koshix):
老人の健康を維持するためには1日に20分以上立っていることが必要だということを聞きました。そこで,(1) スマートフォンだけ,あるいは,(2) スマートフォンと他のウェアラブルデバイスとの組み合わせ,によって,人が立っている時間を記録するアプリを作りたいと考えました。どのような原理とセンサーを用いれば,人間が立っている時間を測定することができるか,そのアイディアと具体的な実現方法を考えてみてください。

A(DeepSeek R1):
人間が立っている時間を測定するためのアプリ開発には、以下のような原理とセンサーの組み合わせが考えられます。スマートフォン単体と複数デバイス併用の両ケースについて具体的に説明します。

【基本原理】
立位状態の判定には「姿勢」「動き」「重力方向」の3要素を組み合わせます。特に重要なのは:
(1) 重力ベクトルの方向(スマホの傾き)
(2) 身体の垂直軸方向の加速度
(3) 高さ変化の検出(オプション)

【ケース1:スマートフォン単体での実現方法】
使用センサー
(1) 加速度センサー
・重力方向の検出:Z軸方向の重力値がほぼ1G(9.8m/s²)かつ安定している場合、直立状態と推定。
・動きの検出:3軸加速度の変動が少ないとき「静止立位」、周期的な変動があれば「歩行中」と区別。
(2) ジャイロセンサー
・姿勢の持続時間:デバイスの傾き角度が一定範囲(±15度以内)を維持した時間を計測。
 例:スマホがポケット内で縦方向に安定 → 立位と判断。
(3) 気圧センサー(搭載機種限定)
・相対高度変化:座る/立つの0.5m程度の高さ差を検出(例:±5hPaの変化をトリガーに)。

【アルゴリズム例】 python # 疑似コード (略)

【課題と対策】
・誤検知対策:椅子に座ったままスマホを机に置くケース → 照度センサーで「ポケット内/手持ち」を判別。
・省電力化:サンプリング間隔を調整(例:静止時は1Hz、動き検出時は10Hz)。

【ケース2:スマートフォン+ウェアラブルデバイスの組み合わせ】
追加センサー
(1) スマートウォッチの心拍数センサー
・静脈パターン変化:手首が心臓より下(垂れ下がった状態)で静脈圧が上昇 → 立位の補助指標。
(2) 骨伝導センサー(イヤホン)
・関節音の検出:膝の伸展時の「ポキッ」という微小な音を検出(実験段階の技術)。
(3) 足首バンドの圧力センサー
・足底荷重検出:直立時に均等な圧力分布が持続する特性を利用。

データ融合の例
複数デバイスのデータを組み合わせて信頼性向上:

【ユーザビリティ向上策】
(1) キャリブレーション機能:
・初回設定時に「立つ」「座る」を指示し、個人のデバイス保持癖を学習。
(2) 誤検知フィードバック:
・ユーザーが手動で誤りを修正すると、AIモデルが継続学習(Active Learning)。
(3) 省電力設計:
・エッジAIで処理(クラウド依存せず)、TensorFlow Liteモデルを使用。

【検証方法】
(1) ベンチマークテスト:
・カメラ映像とセンサーデータを同期記録し、教師データとして使用。
(2) シニア向け調整:
・ゆっくりした動作に対応するため、状態遷移の判定閾値を緩和(例:立ち上がりに5秒以上かかるケース)。

【発展的な応用】
・転倒予防:ふらつき検出(加速度の急激な揺れ)と連動。
・血圧管理:立位時間と健康データ(Apple Health/Google Fit連携)を相関分析。

このように、スマートフォンの基本センサーを活用しつつ、ウェアラブルデバイスを組み合わせることで、より正確な立位時間の測定が可能になります。特に高齢者向けには「誤検知の少なさ」と「操作の簡便さ」のバランスが重要です。


A(ChatGPT o1):
以下では、まず「人が立っている状態をどのような原理で判定できるか」について、考え方をステップバイステップで整理し、そのうえで(1)スマートフォンのみを用いるケースと(2)スマートフォン+ウェアラブルデバイスを用いるケースの具体例を示します。

1.コンテキストと前提条件
「人が立っている状態の検知」は、腰や胸の位置にあるデバイスがどのような姿勢にあるか、あるいは体重のかかり方・重心の変化などをベースに判断できます。
スマートフォンだけで測定する方法と、ウェアラブルデバイスを追加で使う方法では、利用可能なセンサーや精度、実装の容易さが異なります。
特に高齢者が使う場合、「装着位置をどれだけ徹底できるか」「デバイスの充電や操作が煩雑にならないか」など、実際の利用シーンを考慮する必要があります。

2.人が立っている状態を推定するための主な原理
(1) 加速度計(加速度センサー)
・本体が垂直方向にどの程度加速度を受けているか、また姿勢がどう変化しているかを推定する。
・スマートフォンや多くのウェアラブルに標準搭載されているセンサー。
(2) ジャイロセンサー(角速度センサー)
・デバイスの回転や傾きの変化を検知する。
・姿勢の変化(座っている・立ち上がる・歩いている)などを判定するときに有用。
(3) 気圧センサー(バロメーター)
・スマートフォンやスマートウォッチに搭載されている場合、上下方向の移動(高さの変化)を推定できる。
・立ち上がった・しゃがんだなど、高さの小さな変化を捉えられる可能性がある(ただし微妙な変化をしっかり捉えられるほど精度が高いかは機種依存)。
(4) 近接センサー / 人感センサー / カメラ
・外部環境との距離や動きを把握して、立っている状態を推測する方法もあるが、スマホの近接センサーだけでは精度が不十分なことが多い。
・カメラを使う場合、人の姿勢推定アルゴリズム(Pose Estimation)などを適用する方法はあるが、バッテリー消費やプライバシー面で課題がある。
(5) 歩数センサー(ペドメーターAPI) と静止判定
・スマートフォンやスマートウォッチは、OS側で歩行や静止をある程度分類してくれるAPIがある(例:iOSのCore Motion、AndroidのActivity Recognition API など)。
・立って「静止」している場合と「座っている」場合を区別できるかは精度やアルゴリズム次第。ただしモーションAPIで「Standing」を直接判定できるとは限らないため、追加ロジックが必要。

3.スマートフォンのみを用いる場合のアイディアと実装方法
3-1. 装着場所の想定
・スマートフォンを腰の位置(ベルトクリップやポケット)に入れておく。
・「なるべく毎日同じ場所に装着する」ことを利用者に徹底してもらう。
3-2. センサー活用の流れ
(1) 加速度センサーによる傾き・姿勢検知
・加速度センサーの値から、スマホがほぼ垂直にあるか(重力方向と端末の姿勢方向が一致しているか)を確認する。
・人間が立っているときは、腰ベルト付近でスマホが縦方向に近い姿勢になりやすい。一方で、座るときはスマホの角度が変わる(背もたれとの関係や腿との角度など)。
(2) ジャイロセンサーによる動きの検知
・立ち上がる、座るといった動作時の角速度変化を検知し、姿勢遷移を検出する。
(3) Activity Recognition APIの利用(Android/iOS)
・端末のモーション処理APIを用いて、「歩行中」「静止中」などのステータスを取得。
・「静止中」かつ「端末が垂直に近い姿勢」という条件を満たす場合を「立っている」とみなすなどのロジックを組む。
3-3. 実装の例
(1) 単純ルールベース
・一定時間ごと(1秒単位など)に加速度ベクトル(x, y, z)を取得して、そのベクトルが重力方向(9.8m/s^2)とどの程度ズレているかを計算する。
・そのズレが小さい(つまり端末が垂直に近い)&歩数変化がない(=歩いていない)状態が連続した場合を「立位状態」とカウントする。
(2) API活用 + フィルタリング
・OS標準のActivity Recognition(例: Androidなら「STILL」「WALKING」「ON_FOOT」等)を取得。
・STILLの状態が一定秒数続き、スマホの傾きが一定範囲内なら「立位」とカウント。傾きが大きければ「座位」と推定。
・データを5秒ごとにログ化し、合計時間を算出。
3-4. 課題と工夫
・スマートフォンをテーブルやカバンの中に置きっぱなしにすると、加速度が検知されず誤検出が増える。
・スマートフォンの装着位置に依存するため、利用者の協力が必要になる。
・デバイスが古い場合はセンサー精度が低いことがある。

4.スマートフォン+ウェアラブルデバイスを用いる場合のアイディアと実装方法
4-1. 使えるウェアラブルの例
(1) スマートウォッチ
・加速度・ジャイロ・気圧センサーが入っていることが多い。
・歩数計測、立ち上がり、座っている時間のログ機能などが標準アプリに付いていることもある。
(2) スマートシューズ
・足裏の圧力センサーで、足に体重がかかっているかを検知できる。
・立っている・座っているの判定精度が比較的高い。
(3) 腰ベルト型の専用装置
・リハビリや介護分野で市販されている、姿勢判定に特化したデバイスも存在する。
4-2. スマートフォンとの連携によるメリット
(1) 装着の自由度
・スマートフォンはポケットなどに入れたままでも、ウェアラブル側のセンサーから姿勢推定が可能になる。
(2) データの統合
・スマートウォッチから取得した歩数や心拍データ、加速度データをスマホアプリと同期して、細かい姿勢判定に活用できる。
(3) 精度向上
・ウェアラブルは腕や足など人体により近い位置で計測し続けるため、加速度や姿勢変化をより正確に測定可能。
4-3. 実装の例
(1) 腕時計型デバイス + スマホ
・スマートウォッチの加速度データから「立位」と判定される動きを検知したら、Bluetooth等でスマホに通知。
・スマホ側アプリが受け取った時刻と連動して、「いつから立っているか」を計測し、座ったタイミング(=姿勢の変化を検知)で終了時刻を記録。
(2) 体重移動センサー(スマートシューズ) + スマホ
・足裏圧力が安定している場合を「立位」、不安定(分散が大きい)なら歩行や走行中、といった分類を行う。
・座位の場合は足への荷重が極端に減るため、閾値判定によって立位/座位を見分けやすい。
・スマホとはアプリやクラウド経由でデータを共有し、立っている合計時間を管理する。
4-4. 開発上の注意点
・ウェアラブルのバッテリー消費量を意識する:常にセンサーを高頻度でスキャンすると電池が早く切れる。
・高齢者が利用する場合、デバイスの装着が苦にならない設計が必要:腕時計タイプであれば普段から装着してもらえるが、足に何かつける場合は履き替えなどの煩雑さがないか考慮する。

5.まとめ
アイディアのポイント
(1) 基本は加速度センサーとジャイロセンサーが要
・スマホのみの場合はActivity Recognitionの利用や、スマホの傾き+静止判定を組み合わせて立位時間を推計。
(2) ウェアラブルを使うと精度・利便性が上がる
・腕時計型・足裏センサーなど、身体に近い場所で計測すると姿勢推定が簡単になり、アプリ側でのロジックも複雑になりすぎない。
(3) 利用者側の負担を減らす工夫
・特に高齢者向けでは、設定や充電、装着場所の固定など、ユーザーがミスしにくい仕組みづくりが重要。

以上のように、スマートフォン単体の場合でも加速度・ジャイロセンサーやOSのActivity Recognitionを活用すれば実現は可能です。しかし、利用者が毎回スマホをポケットや腰付近に装着してくれる前提がないと精度が低下することが多いです。その点、腕時計型ウェアラブルや足裏センサー等と連携することで、より精度の高い立位時間の計測や動作推定がしやすくなるでしょう。


図:立ちタイムのイメージポスター(DALL-E3による)


P. S. 灯台下暗し。隣のApple Watch ユーザによれば,Apple Watch はときどき「立ってね」とスタンドアップを促すそうだ。スタンドリマインダーというらしい。
「スタンドリマインダー」は、Apple Watchを装着している状態で1時間のうち最初の50分間座り続けている場合に「スタンドの時間です!」とメッセージ通知され、座り続けていることを予防する機能となっています。
Apple Watchでは1日の1時間当たり1分以上立っていた回数を測定しており、「アクティビティ」アプリの画面でその結果を確認することができます。(iPhone Wave から引用)

2025年2月8日土曜日

教員の学力低下

2月5日のNewsWeek日本版に,教職不人気で加速する「教員の学力低下」の深刻度という教育社会学者の舞田敏彦(1976-)の記事が出た。舞田さんはデータ分析の新しい切り口をいつも見せてくれる面白い人だ。

結論を一言でいえば,「新規採用教員のうち4割近くの出身学部の入試偏差値は50に満たない」ということだ。旺文社の『大学の真の実力2025』にある,関東1都6県の231大学・865学部からの教員就職者は9454人(2024年春)を,出身大学のタイプで分けて分析したものだ。あわせて,公務員就職者や全就職者も比較の対象として分析している。

そのオリジナルの表を元校長のyoshiさんが編集し直したものが下記に引用した図である。教職がブラック性が広まり,一般の企業の就職が堅調であることから,教員採用倍率の低下がこのところ続いている。これによって,教員就職者の学力の平均が低下していることを裏付けるデータになっている。


図:就職者の出身大学と偏差値(yoshiの教育ブログから引用)

ChatGPT 4o,Gemini 2.0 Flash,Claude 3.5 Sonnet,などは,イメージファイルを読み込んで分析することができる。Perplexity Pro は有料版に誘導され,DeepSeek V3とQwen2.5-Max はイメージの読み込みができない。上記の図を入力してみたところ,それぞれそれなりに分析してくれた。Gemini 2.0 Flash はピントがズレていていまいちだ。Claude 3.5 Sonnet は要点を正確かつ簡潔に19行でまとめた。ChatGPT 4o がより詳しい分析を与えてくれる。
Q(koshix):
(図のjpgファイルをアップロードした上で)
このグラフからわかることを分析してください

A(ChatGPT 4o):
このグラフからわかるポイントを分析すると、以下のようになります。

1.教員の出身大学偏差値と傾向
・私立大学偏差値50未満の出身者が圧倒的に多い
→ 教員(緑のバー)の割合が 37.9% と突出しており、他の職種(全就職者・公務員)と比べて明らかに高い。
→ これは、私立大学の偏差値が低めの層から教員になる人が多い傾向を示している。
・偏差値が高い大学(国公立、私立偏差値65以上)出身の教員は少ない
→ 国公立大学出身の教員は 15.2% にとどまり、私立偏差値65以上は 5.3% にとどまる。
→ 高偏差値の大学から教員になる割合は低めであり、教育職が高学歴層にとって魅力的なキャリアになっていない可能性がある。

2.公務員(赤のバー)の傾向
・比較的バランスが取れている
→ 公務員は国公立出身 13.7%、私立偏差値65以上 19.5%、偏差値50~60の範囲で比較的均等に分布。
→ 偏差値が高い大学出身者も一定数公務員になっている。
・私立大学偏差値50未満の割合はやや低め(19.8%)
→ 教員と比べると、公務員はやや高偏差値の大学出身者が多い。

3.全就職者(青のバー)の傾向
・私立大学偏差値50未満が多い(28.4%)が、教員ほどではない
→ 教員と比較すると、企業などの就職先の方が高偏差値大学の出身者が分散している。
・国公立大学の出身者は少なめ(6.6%)
→ 企業に就職する人は国公立大学出身者よりも私立大学出身者の方が多い。

4.重要なポイント
・教員の偏差値50未満の大学出身者が非常に多い(37.9%)
→ 赤い矢印で強調されている通り、教員は低偏差値の大学出身者が占める割合が非常に高い。
→ これは、教育界が高学歴層にとって魅力的でない、あるいは給与や待遇面で課題がある可能性を示唆。
・高偏差値大学出身者は公務員や企業に流れる傾向がある
→ 私立大学偏差値65以上の出身者は公務員(19.5%)の方が教員(5.3%)よりも多い。

結論
このデータから、日本の教育業界が高学歴層を十分に惹きつけられていない可能性が示唆される。教員の待遇やキャリアパスの改善が必要と考えられる。また、私立大学の低偏差値層から教員になる人が多いことが、教育の質や社会的な評価にどう影響するのかも考察すべきポイントである。

2025年2月7日金曜日

単語あてと推論AI

四則演算と推論AIからの続き

「索引たんご」というパズルゲームがある。5文字の日本語の単語をあてるのだが,この単語は,「あああああ」から「んんんんん」の範囲にある5文字のアイウエオの辞書順並びのどこかに埋っている。適当な5文字単語を入れると,それがこのパズルゲームの辞書にあれば,正解の前または後にあることが分かり上書き挿入される。これを繰り返すと,正解の単語がどんどん絞り込まれていくというわけだ。

試してみると,8回目のトライで「くわばたけ」と「くんじょう」の間までたどり着いた。トライ数の上限は12回だ。この先がななかか思い浮かばないので,いつものように生成AI諸氏にお願いしてみた。悪い癖だ。


図:索引たんごの実行例(https://puzzlega.me/から引用)

Q(koshix):
日本語の5文字からなる単語です。 辞書のアイウエオ順で, 「くわばたけ」と「くんじょう」の間にあります。 それは何でしょうか。

(1) ChatGPT 4o:
10行の解説に続く答えは「くわばら」。チーン。

(2) ChatGPT o3-mini-high:
この推論モデルは,221秒かけて423行の考察のあと,最終回答として「くわばたこ」を提案してきた。そんな単語はありません。

(3) Gemini 2.0 Flash:
すぐに答えが出てきた。「くんしゅ(君主)」。間違っています。

(4) Gemini 2.0 Flash Thinking Experimental:
You're using 2.0 Flash Thinking Experimental with reasoning across Google apps. Works best with YouTube, Maps, and Search. Some Gemini features aren't available.
はいはい。英語で67行考えた結果,答えは「くさいろ(草色)」
大阪教育大学のウェブサイトで公開されている辞書データの一部を確認したところ](https://www.google.com/search?q=http://www.osaka-kyoiku.ac.jp/~nonami/awk/goibunseki/goidata.txt)%E3%81%A7%E5%85%AC%E9%96%8B%E3%81%95%E3%82%8C%E3%81%A6%E3%81%84%E3%82%8B%E8%BE%9E%E6%9B%B8%E3%83%87%E3%83%BC%E3%82%BF%E3%81%AE%E4%B8%80%E9%83%A8%E3%82%92%E7%A2%BA%E8%AA%8D%E3%81%97%E3%81%9F%E3%81%A8%E3%81%93%E3%82%8D)、提示された単語の順番が確認できました。

と親切に教えてくれた。野浪先生のページだ。

(5) Claude 3.5 Sonnet:
Due to unexpected capacity constraints, Claude is unable to respond to your message. Please try again soon. Or consider upgrading to Claude Pro.
どうやら問題が難しすぎたようだ。

(6) Perplexity Pro:
今回唯一正しい答えを回答してきた。
「くわばたけ」と「くんじょう」の間に位置する5文字の単語は、以下の3つが該当します
くんこがく(訓詁学) 古典の解釈を研究する学問分野。
くんしゃく(勲爵) 功績のある人物に与えられる爵位の称号。
くんしょう(勲章) 功績を称えて授与される記章。
五十音順では「くわばたけ」→「くんこがく」→「くんしゃく」→「くんしょう」→「くんじょう」と並びます。この問題の意図に沿う最も典型的な回答は「くんしゃく(勲爵)」と考えられます。
「くんしょう(勲章)」はパズルゲームの辞書にはあったが,正解ではなかった。「くんこがく(訓詁学)」と「くんしゃく(勲爵)」はパズルゲームの辞書(12000語)にはないのだ。惜しかった。

(7) DeesSeek V3:
日本語の前フリが86行もある。答えは「くんれん」。だめだこりゃ。

(8) DeepSeek R1:
苦しんでいる。中国語で351秒考えていた。推論にかかったのは285行。
そのあげくの答えは,「くんぴら(組痞羅)」なんだそれは。

(9) Qwen2.5-Max:
すぐに4文字の候補を3つあげてきた。答えは「くらしき」。ブー。

(10) Qwen 2.5-Plus:
Plusは18兆トークンで,会話に強いらしいが,
4文字の候補を3つで,答えは「くらやま」。ブー。

(11) PLaMo:
国産LLMのはずなのだけれども,ほとんど役に立たない。
申し訳ありませんが、日本語の五十音図において「くわばたけ」と「くんじょう」の間に位置する単語に関してお答えすることはできません。

「くわばたけ」の後に続く単語としては、辞書によって異なりますが例えば「くさかり」や「くさはえ」といった単語がありますが、「くわばたけ」の後に位置する単語が五十音図の順番で決まっているわけではありません。そのため「くわばたけ」と「くんじょう」の間に特定の単語があるかどうかも不明です。

「くんじょう」の前に続く単語としては例えば「くうそう」「ぐらい」「くうちゅう」「くうき」などがありますが、こちらも辞書によって順序が異なるため、こちらの方向から特定の単語をお探しすることも難しいと考えられます。

もしよろしければ、お探しの単語をもう少し詳細にご教授いただけますでしょうか?精一杯お調べし、回答いたします。
結論:推論モデルは意外に単純な問題で弱点を抱えている。全体に日本語の文字カウントが苦手らしい。トークン単位で処理する連中だからか。そういえば,俳句も苦手だった。日本語のLLMの開発が強く求められている。それができないと,クリスタル・インテリジェンスも深いところで弱点を持ったままになるのではないか。

P. S. その後,人力で大辞林(物書堂)の力を借りながらやってみると,挑戦回数11/12でようやく「ぐんしゅう」という正解にたどりつくことができた。


図:ようやくたどりついた正解(https://puzzlega.me/から引用)

2025年2月6日木曜日

四則演算と推論AI

今あるAIは単純な計算が苦手だという説がある。例えば,9.11と9.8の大小関係を間違うとか,桁数が多い四則演算ができないとかいわれる。そこで試してみた。
問題は,「135797531*246808642-98765432123456789 = -65249427910393887」だ。
被乗数9桁,乗数9桁,途中の積は,33516004213062902であり17桁ある。

(1) Excel:
数表示を会計にする。引く数の98765432123456789 を入力した段階で 98765432123456700 に丸められてしまう。結果は, ¥ -65,249,427,910,393,800 と不完全なものにしかならない。

(2) Mathematica:
Timing[135797531*246808642 - 98765432123456789] → {0.000021, -65249427910393887}
答えは21μsで正解が得られる。これが Julia ならば,1μs未満である。
もちろん,macOSのコマンドラインのbc -l でも一瞬で正解がでてくるのだ。

(3) ChatGPT 4o:
 "The result of the calculation is −65,249,427,910,393,887. ​​"
分析を表示させると,これはpythonに計算を投げている。正しい答えが一瞬で得られた。

(4) ChatGPT o3-mini-high:
この推論モデルでは思考に21秒(推論に35行)かかっている。計算を簡単にするため?乗数を246808642=246000000+808642 と分割してそれぞれの掛け算した結果を後に合わせている。
引き算の部分でも,33516004213062902を33000000000000000 と 516004213062902 に分割して処理するのだ。ご苦労様。
 「このように、与えられた式の計算結果は -65,249,427,910,393,887 となります。」
あってるよ。

(4) Gemini 2.0 Flash:
一瞬で計算が拒否された。
 "The data_analysis library is not useful for this type of queries."

(5) Claude 3.5 Sonnet:
 Let me calculate this multiplication and subtraction step by step:
 First, I'll multiply 135797531 and 246808642
 135797531 * 246808642 = 33,516,832,759,528,762
 Then I'll subtract 98765432123456789 from the result
 33,516,832,759,528,762 - 98,765,432,123,456,789 = -65,248,599,363,928,027
 The final answer is -65,248,599,363,928,027.
答えは一瞬ででてきたものの,有効数字上4-5桁しか正しくないですよ。

(6) DeepSeek R1:
221秒考えていた。推論に880行ほど費やしている。もうだめかと思った。
どうやら,a = 135,000,000,b = 797,531,c = 246,000,000,d = 808,642,So (a + b)(c + d) = ac + ad + bc + bd を用いているらしいが,思考の過程をフォローするのは面倒すぎる。
 "The final result of the expression is −65249427910393887"
答えは正しいぞ。

(7) Qwen2.5-Max :
  "The result of 135797531×246808642−98765432123456789 is: −65278419668870567"
掛け算と引き算の2段階に分けて答えはすらすらとでたが,有効数字3桁しか正しくない。

以上でした。ChatGPTはやはりお薦めかもしれない。


図:Imagen3 が描いてくれたマンガだが,あまりよくわからない。

2025年2月5日水曜日

クリスタル・インテリジェンス

2月3日,石破首相に孫正義(1957-)と来日したサム・アルトマン(1985-)が面会しているニュースやサム・アルトマンの東大での対話集会などをみていてもピンと来なかった。ところが同日,日本企業500社などを集めてソフトバンクが開催したイベント「AIによる法人ビジネスの変革」の動画をYouTubeでみてあっと驚いた。

ソフトバンクとOpenAIが50%ずつ出資して企業向けAIシステムを開発するSB OpenAI Japanという合弁会社を設立する。その会社の製品名が,クリスタル・インテリジェンス(Cristal Intelligence)である(注:Cristal や type ではなくて商標用の単語)。

クリスタル・インテリジェンスについての孫さんの説明はたいへんわかりやすかった。このAIシステムに企業(企業グループ)が持つ千オーダーのデータベースのソースコードを全部ぶち込むのだ。そして,それぞれのモジュールが何を意味するのかをAIに完全に把握させ,バク出しや改良を行う。これによってソフトウエア維持開発費用が圧倒的に縮減できる。もちろん過去のレガシーCOBOLプログラム問題も解決する。

この他にも,社内の全会議にAIを参加させてその内容を記録するとともに提案させる。全コールセンターをAIで代替する。外部との全ネゴシエーションにAIを同席させるなどなど。このクリスタル・インテリジェンスは各企業専用に準備され,先の合弁会社SB OpenAI Japanが導入とメンテナンスを行う。もちろん企業の秘密は完全に守られる。データーセンターは,スターゲート計画の一環として日本に設置される。しかも,これらの情報は長期記憶として保存されて当該企業AI(クリスタル・インテリジェンス)の推論や判断に利用される。

話を聞きはじめたときには,1000万円くらいのシステムをつくるのかと思っていたが,とんでもない。年間使用料は,最初にこのシステムを導入するソフトバンクグループ(売上高6.7兆円,従業員数6.5万人,総資産46.7兆円)で4500億円/年だというのだ。これがSB OpenAI Japanの手元に入る。世界にあるこの規模の企業グループ100社が導入すれば年間45兆円の収益が得られ,OpenAIのビジネスモデルが確立することになる。

もちろん,政府や行政等の組織へのバリエーションも考えられるだろう。問題は中国製の安価な対抗馬の発生にどう対応するかだろうが,情報の秘匿性の問題があるため,現行体制の中国ならば対応可能ではないか。

本当の問題は,このようなシステムが普及したときに人間に残されるのはどんな仕事なのかということだ。組織の意思決定や情報システムや研究開発やマーケティングや法務などの中核部分はすべて置き換えられてしまう。残されたのは投資家と周辺の雑務労働者だけとなる。電力会社のエリート層が動かす原子力発電所の維持が,結局のところ多重下請けで放射性物質に汚染されざるを得ない労働者なしには進まないように。


図:Cristalのイメージ(ソフトバンクから引用)

[1]ソフトバンクとOpenAI、大企業AI「クリスタル」を日本先行導入 合弁会社設立(Impress Watch)

2025年2月4日火曜日

トランプ革命

トランプ革命が進んでいる。これによって今にも廃止されてしまいそうな米合衆国教育省にDEIプログラム廃止のアナウンス(January 23 2025)が出ていた。

DeepLに翻訳させると次のようになる。
ワシントン - 米国教育省は、公的なコミュニケーション・チャンネルや関連する労働力における言及を含め、有害な多様性・公平性・包括性(DEI)イニシアチブを排除するための行動をとった。これらの行動は、連邦政府全体の違法な差別や無駄遣いをなくすというトランプ大統領の継続的なコミットメントに沿ったものである。これらは、学校における分断的なイデオロギーよりも有意義な学習を優先させる方向へ、政府機関を方向転換させる第一歩である。

トランプ大統領の最近の大統領令と人事管理局(OPM)の最初のガイダンスを受け、同省は対外的なコミュニケーション・チャネルからDEIに関する言及を含む何百ものガイダンス文書、報告書、研修資料を削除またはアーカイブした。同省はまた、DEIイニシアチブのリーダーを務める職員を有給休暇にした。このような見直しの努力は、省庁内およびアメリカの教育システム全体において、人種に基づく差別や有害な人種ステレオタイプの使用をなくすために省庁が取り組む中で継続される。

同省がとった注目すべき行動には以下が含まれる: 

・同省のダイバーシティ&インクルージョン・カウンシルの解散;
背景:ダイバーシティ&インクルージョン評議会は、オバマ大統領(当時)の大統領令13583に従って設立された。トランプ大統領は、同協議会を指導する大統領令を取り消し、「過激で無駄の多い政府のDEIプログラムおよび優遇措置の廃止」という新たな大統領令を発令し、多様性・包摂協議会のようなグループを廃止した。協議会が発行したDEI文書や関連する行動は撤回された。
・トランプ大統領の大統領令「過激で無駄の多い政府のDEIプログラムと優遇措置の廃止」に従い、公民権局(OCR)内の従業員参加型多様性公正包括性協議会(EEDIAC)を即時解散;
・総額260万ドルを超える継続中のDEIトレーニングおよびサービス契約の取り消し;
・同局の公平性行動計画の撤回;
・前政権のDEIイニシアチブの実施を任務とするキャリア職員の有給休職。
・DEIリソースを収容し、有害なイデオロギープログラムを促進または支持する学校や高等教育機関を奨励する省のウェブサイトから200以上のWebページを削除するための識別。 
OPMのガイダンスに従い、同省は全省庁のプログラムとサービスの包括的なレビューを継続し、活動を偽装するためにコード化された、または不正確な言語を使用しているプログラムを含む、分裂的なDEIアジェンダを推進している可能性のある追加のイニシアチブとワーキンググループを特定する。また、DEIの言語やリソースについて、すべての公共サイトやメディアチャンネルを注意深く見直すことも継続する。
どこかに多様性・公平性・包括性に関するDEIリソースをバックアップしないと,重要なデータごとみな抹殺されてしまいそうだ(ニューヨークタイムズによるともろもろ8000ページの公的機関のページが削除されている)。あいまいな弱者が支えるN国と維新と国民民主の連合軍に象徴される新自由主義的な取り巻きは,日本のトランプ革命の萌芽なので要注意。


図:トランプ革命のイメージ(Imagen3による*注)

*注:トランプ革命のイメージで発注すると,ChatGPTやGeminiやDeepSeekにはあっさり拒否されてしまう。しかたがないのでQwen2.5-Maxに頼むと抽象的なプロンプトを作ってくれた。これを再度Geminiに入れるとなんとか無難なイメージは生成することができた。

2025年2月3日月曜日

ChatGPT o3-mini(1)

TikZのカメ(2)からの続き

1月31日にOpenAIから一般向けにリリースされた ChatGPT o3-mini である。すごく評判がいい。一般の二次関数の逆数の定積分や平方根の定積分は軽々と実行したが,これはどこにでも公式がのっているようなものなので検証の役には立たない。

こうなってくると人間のアイディアの方がAIの処理能力に追いつかないのである。とりあえず比較のためにカメのTIkZイメージを同じように作らせてみた。残念ながら一発でコードが通らなかったのだが,エラー部分を入れてみるとすぐに実行可能なコードがでてきた。その結果が下図である。立体的な表現ができるようになり,足と頭と尾の位置はそれぞれもっともらしいところにある。


図:OpenAI o3-mini-highによるカメのイメージ

以下が,OpenAI o1 にまとめさせたOpenAI o3-mini の概要だ。
OpenAIは、新たな推論モデル「o3-mini」をリリースしました。このモデルは、科学、数学、コーディングなどのSTEM分野での優れた性能を持ち、従来の「o1-mini」と比較して低コストかつ低遅延を実現しています。 

o3-miniは、関数呼び出し、構造化出力、開発者メッセージなど、開発者から要望の多かった機能をサポートしており、すぐにプロダクション環境での利用が可能です。また、推論の深さを「低」「中」「高」の3段階から選択でき、タスクの複雑さや速度要件に応じて最適化できます。ただし、視覚的なタスクには対応していないため、画像や視覚情報を扱う場合は「o1」モデルの使用が推奨されています。 

OpenAIのPlus、Team、Proユーザーは、本日よりo3-miniにアクセス可能で、Enterpriseユーザー向けには2月から提供が開始されます。o3-miniは、従来のo1-miniに代わり、より高いレート制限と低遅延を提供し、特にコーディングやSTEM関連の問題解決に適しています。さらに、PlusおよびTeamユーザー向けのメッセージ制限が1日50件から150件に増加しました。無料プランのユーザーも、メッセージ作成時に「Reason」オプションを選択することで、初めて推論モデルを試すことができます。

o3-miniは、特に技術的な分野での精度と速度を求めるユーザーにとって、有力な選択肢となります。ChatGPT内では、デフォルトで中程度の推論深度が設定されており、速度と精度のバランスが取れています。また、全ての有料ユーザーは、モデルピッカーで「o3-mini-high」を選択することで、より高度な推論を行うバージョンを利用できます。Proユーザーは、これらのモデルに無制限にアクセス可能です。 


\begin{tikzpicture}[scale=1]
% OpenAI o3-mini-high
%
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % カメの甲羅: 大きな楕円にグラデーションシェーディング
  \shade[ball color=green!30!blue, opacity=0.9] (0,0) ellipse (3cm and 2cm);
  \draw[line width=1pt, color=green!80!black] (0,0) ellipse (3cm and 2cm);
  
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % 甲羅の装飾: ウロコ風の模様(小さな円)
  \foreach \pos in {(-1.2,0.5), (1.2,-0.5), (0,1), (-0.8,-0.7), (0.8,0.8)}
  {
    \draw[fill=green!60!black, opacity=0.8] \pos circle (0.3cm);
  }
  
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % カメの頭: 右側に配置
  \begin{scope}[shift={(3.5,0.5)}]
    \shade[ball color=yellow!80!orange, opacity=0.95] (0,0) ellipse (0.8cm and 0.6cm);
    \draw[line width=1pt, color=orange!80!black] (0,0) ellipse (0.8cm and 0.6cm);
    % 目の描画
    \fill[white] (0.3,0.15) circle (0.15cm);
    \fill[black] (0.33,0.15) circle (0.07cm);
  \end{scope}
  
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % カメの足: 前右、前左、後右、後左の4箇所に配置
  \foreach \x/\y in {(1.8,2.0), (-1.8,2.0), (1.8,-2.0), (-1.8,-2.0)}
  {
    \begin{scope}[shift={(\x,\y)}]
      \shade[ball color=green!50!yellow, opacity=0.95] (0,0) ellipse (0.5cm and 0.3cm);
      \draw[line width=1pt, color=green!70!black] (0,0) ellipse (0.5cm and 0.3cm);
    \end{scope}
  }
   %%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % カメの尻尾: 左側に配置
  \begin{scope}[shift={(-3.2,0)}]
    \shade[ball color=green!50!yellow, opacity=0.95] (0,0) ellipse (0.4cm and 0.2cm);
    \draw[line width=1pt, color=green!70!black] (0,0) ellipse (0.4cm and 0.2cm);
  \end{scope}
  
%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%%
  % 背景装飾: 水しぶきのような曲線(オプション)
  \draw[blue!50, thick, decoration={random steps,segment length=3mm,amplitude=1mm}, decorate] 
        (-3, -2.5) .. controls (0, -3) .. (3, -2.5);

\end{tikzpicture}

2025年2月2日日曜日

世界終末時計

NHKのニュース9で世界終末時計の話題を取上げていた。

Bulletin of the Atomic Scientists (原子力科学者会報)の表紙絵のDoomsday Clocksとして有名なものであり,核戦争などによって世界が滅亡する時刻を午前0時として,それまでにあとどのくらい時間が残されているかを示すものだ。

1947年の7分前からはじまり,自分の生まれた1953年に米ソの水爆実験が始まり2分前まで縮まった。大学に進学した1972年には核軍縮のプロセスが進行して12分前まで戻した。さらに,結婚後奈良に転居する1991年には東西冷戦の終了後のソ連邦の崩壊で17分前に至る。

しかしそれからは坂を転がるように危機的な要素が次第に加わったため,トランプが第二期目の大統領になってとうとうこれまで最短の89秒前になってしまったというニュースだ。

下図は6年のオフセットでほとんど自分の人生と重なってくる図だ。このまま人類は滅亡するのだろうか。最初は核戦争だけが主要因子だったが,その後,地球温暖化が追加の因子として加わった。さらに,国家予算に対してマンハッタン計画と同程度のパーセンテージの資金を投入しようとしているAI開発競争が第3の因子として立ち上がってきた。

そこに,米中対立をシンボライズするようなDeepSeekの登場がかさなるという図になる。メキシコ湾とデナリの例に続いて,世界中で反動の嵐が吹きまくり,世界共通の固有名詞がバラバラに解体されて異なった文化によって複製変異されることになるかもしれない。

もう,斎藤知事派と反斉藤知事派,ジャニーズ派と反ジャニーズ派,トランプ派と反トランプ派の間にはバベルの塔を崩壊に導いたあの神(AI)の怒りだけが渦巻いている。


図:世界終末時計(Wikipediaから引用)

P. S. Doomsdayで思い出したコニー・ウィリスのドゥームズデイ・ブックは審判の日のための財産台帳だったのか。世界終末時計が午前0時を指すと,すべての人類への魔法が解けて,みなネズミやヘビに帰着してしまう。それまでに,人類全員のドゥームズデイ・ブックを作って,その情報記憶をきざんだ墓石星を宇宙空間に放出できるだろうか。

2025年2月1日土曜日

TikZのカメ(2)

TikZのカメ(1)からの続き

ChatGPTのプログラムコードではじめて絵を描かせてみたのが2年前のマインドマップのつたない線画だった。半年前にはそのテクニックで,Claude 3.5 Sonnetによるカメを描いた。だいぶ進化していた。

この度,推論モデルが登場したので,再度TikZによる描画に挑戦してみた。参加メンバーは,(1) Chat GPT o1,(2) Gemini 2.0 Flash,(3) Qwen2.5-Max,(4) DeepSeek R1の4種類である。ただし,新登場の(3) Qwen2.5-Maxだけは推論モデルには該当しないことに注意する。


図:TikZによる各生成AIが保持しているカメのイメージ
(1) 左上:ChatGPT o1,(2) 右上:Gemini 2.0 Flash
(3) 左下:Qwen2.5-Max,(4) 右下:DeepSeek R1 

半年前よりは少し進化しているかもしれない。彼ら生成AIは,カメが甲羅と頭としっぽと四本の短い足から成り立っていることを知っている。また,緑色や茶色が基調色として採用されている。今回は,グラデ—ションや中間色の表現が登場した。DeepSeekR1は本体の足の取り扱いは残念なのだが背景の水や泡にまで思いが及ぶようになっている。